 Djinious





Site reliability
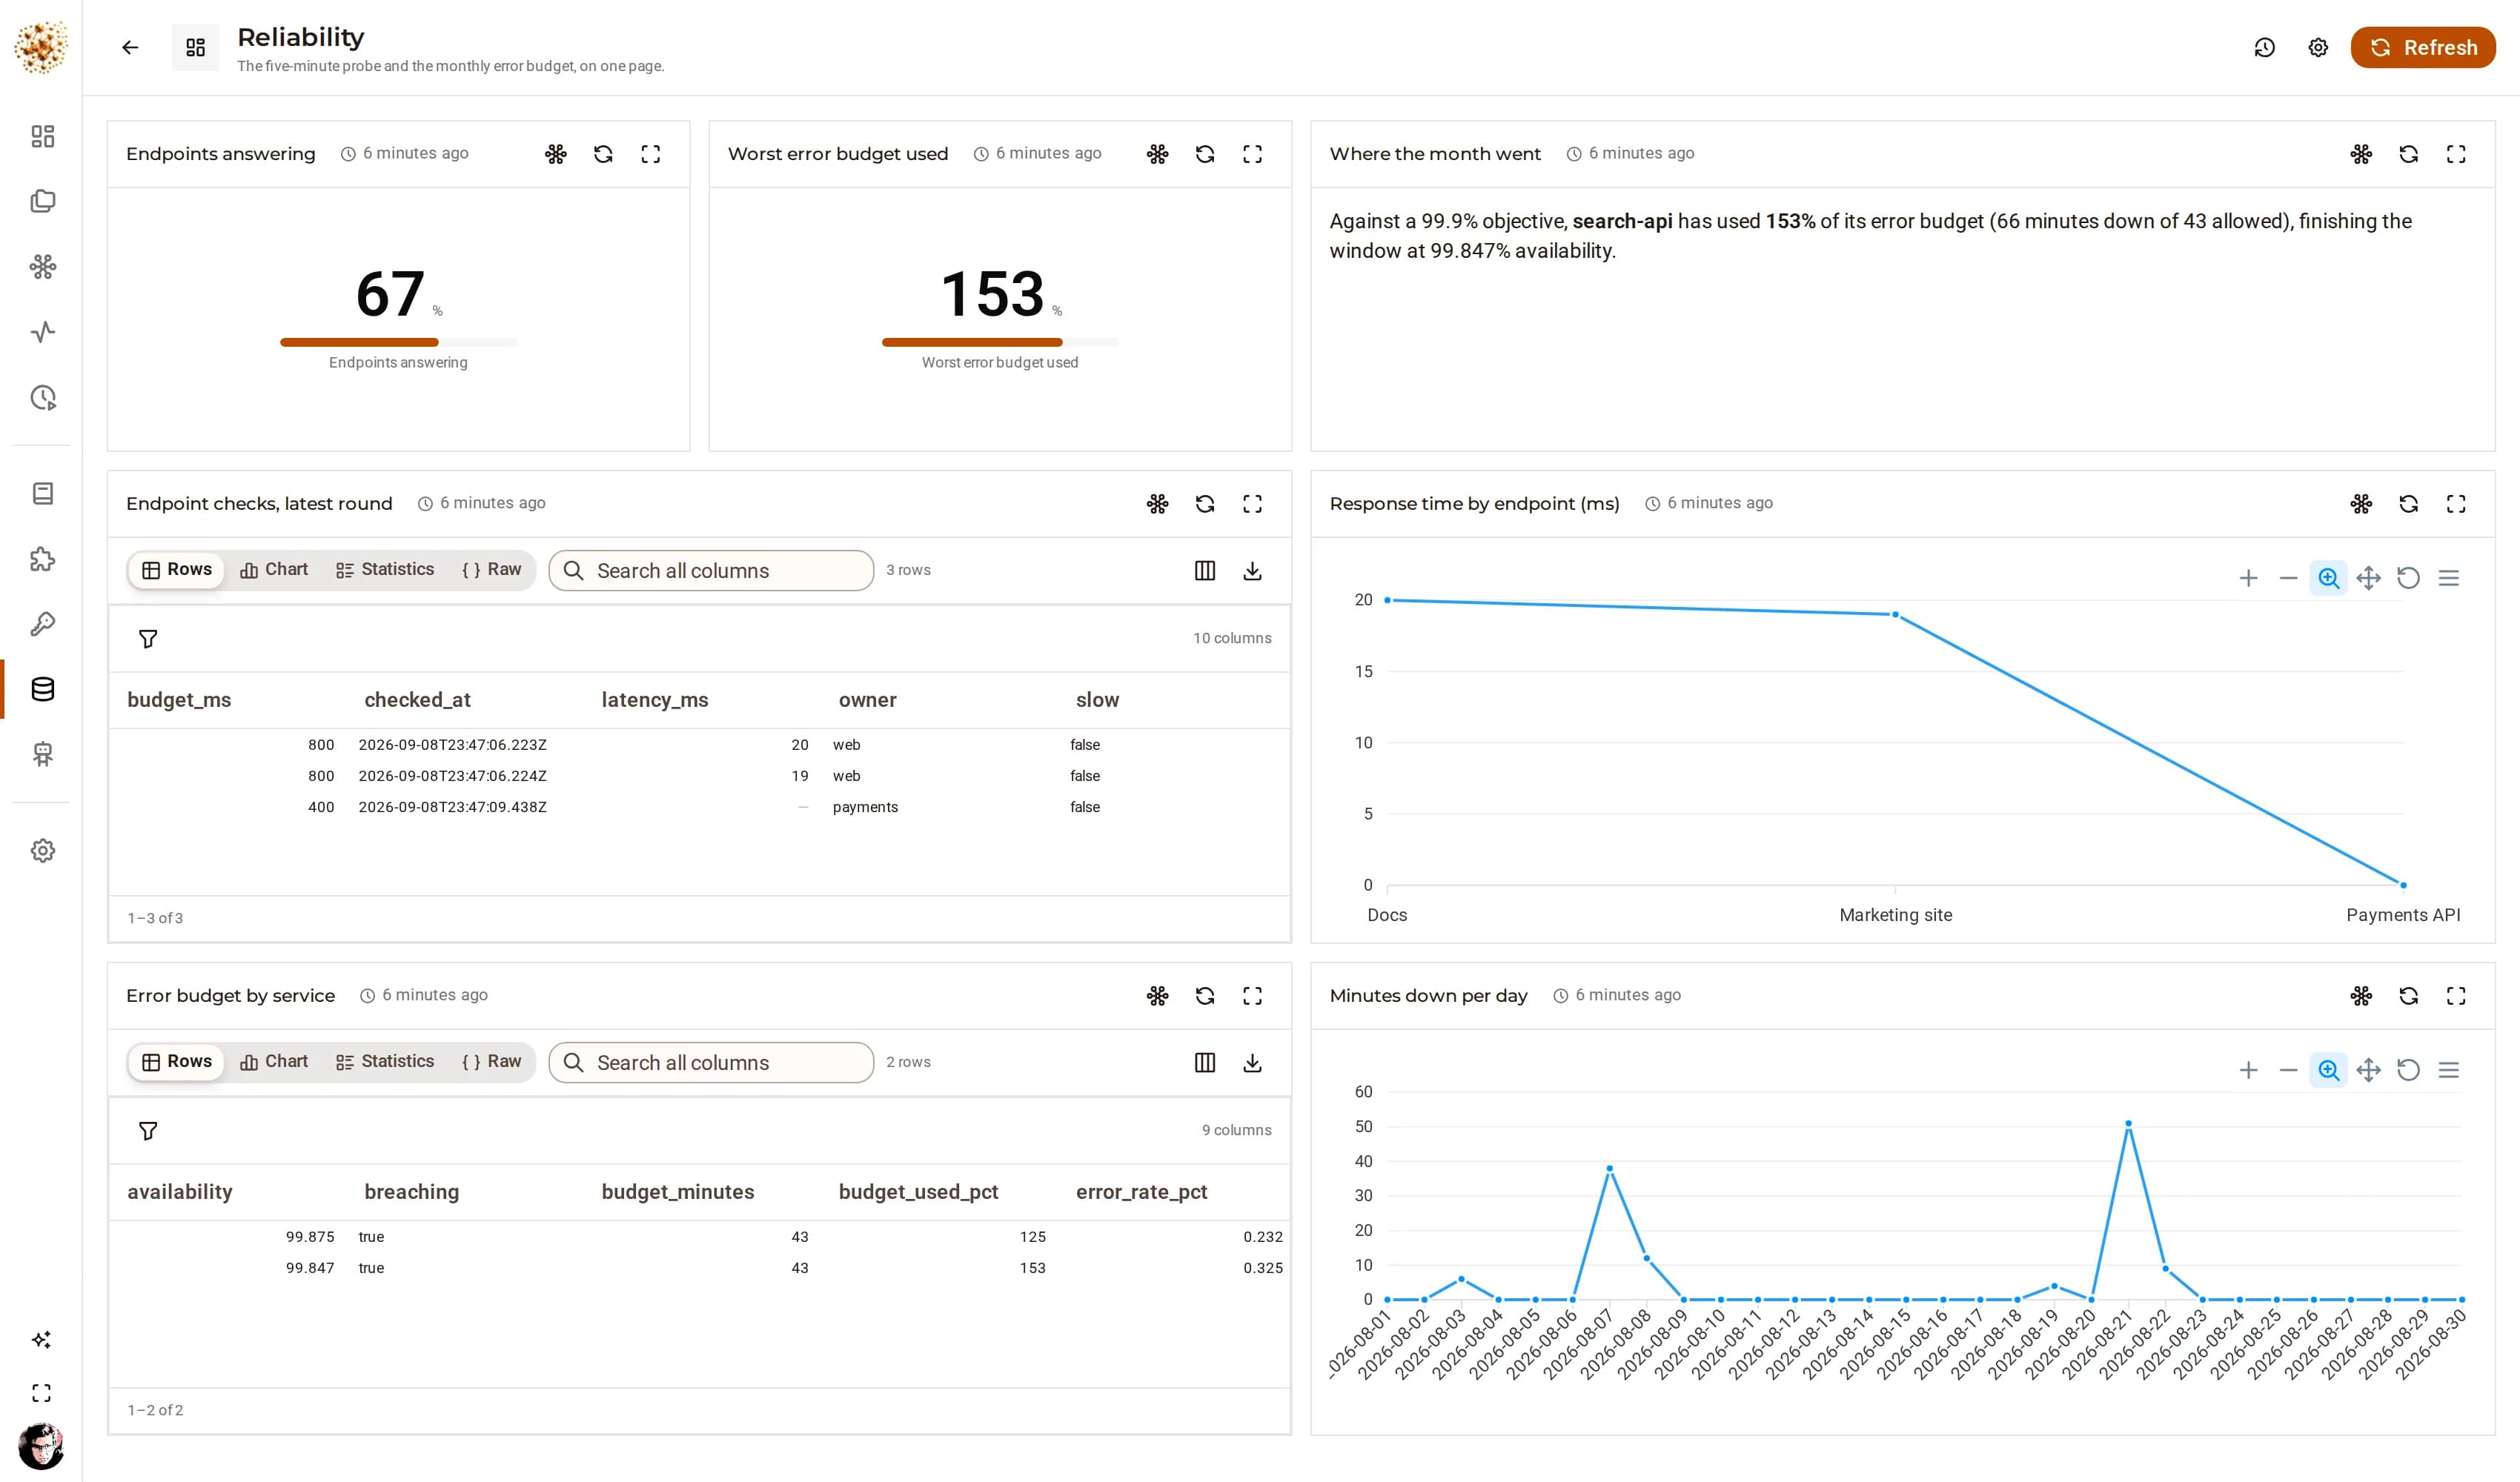
Endpoint sondati in parallelo, incidenti aperti dal guasto stesso, e nulla che raggiunge una pagina di stato pubblica senza che una persona approvi le parole.
 DjiniousWorkflow
Retry · rami di errore · gate umano
Il grafo del probe osserva deliberatamente un endpoint che non si risolve. Ritenta due volte con backoff, esce dal ramo di errore, apre un record di incidente e avvisa il team proprietario — e l’esecuzione finisce comunque verde con i due controlli sani riportati, perché è ciò che il grafo dice debba accadere.
Il grafo di intake instrada un alert per gravità, fa redigere a un modello la frase rivolta al cliente, e poi si ferma: l’approvazione è una riga di database, quindi l’esecuzione attende per tutto il tempo che serve alla decisione.
Il probe, così come è stato eseguito
DjiniousWorkflow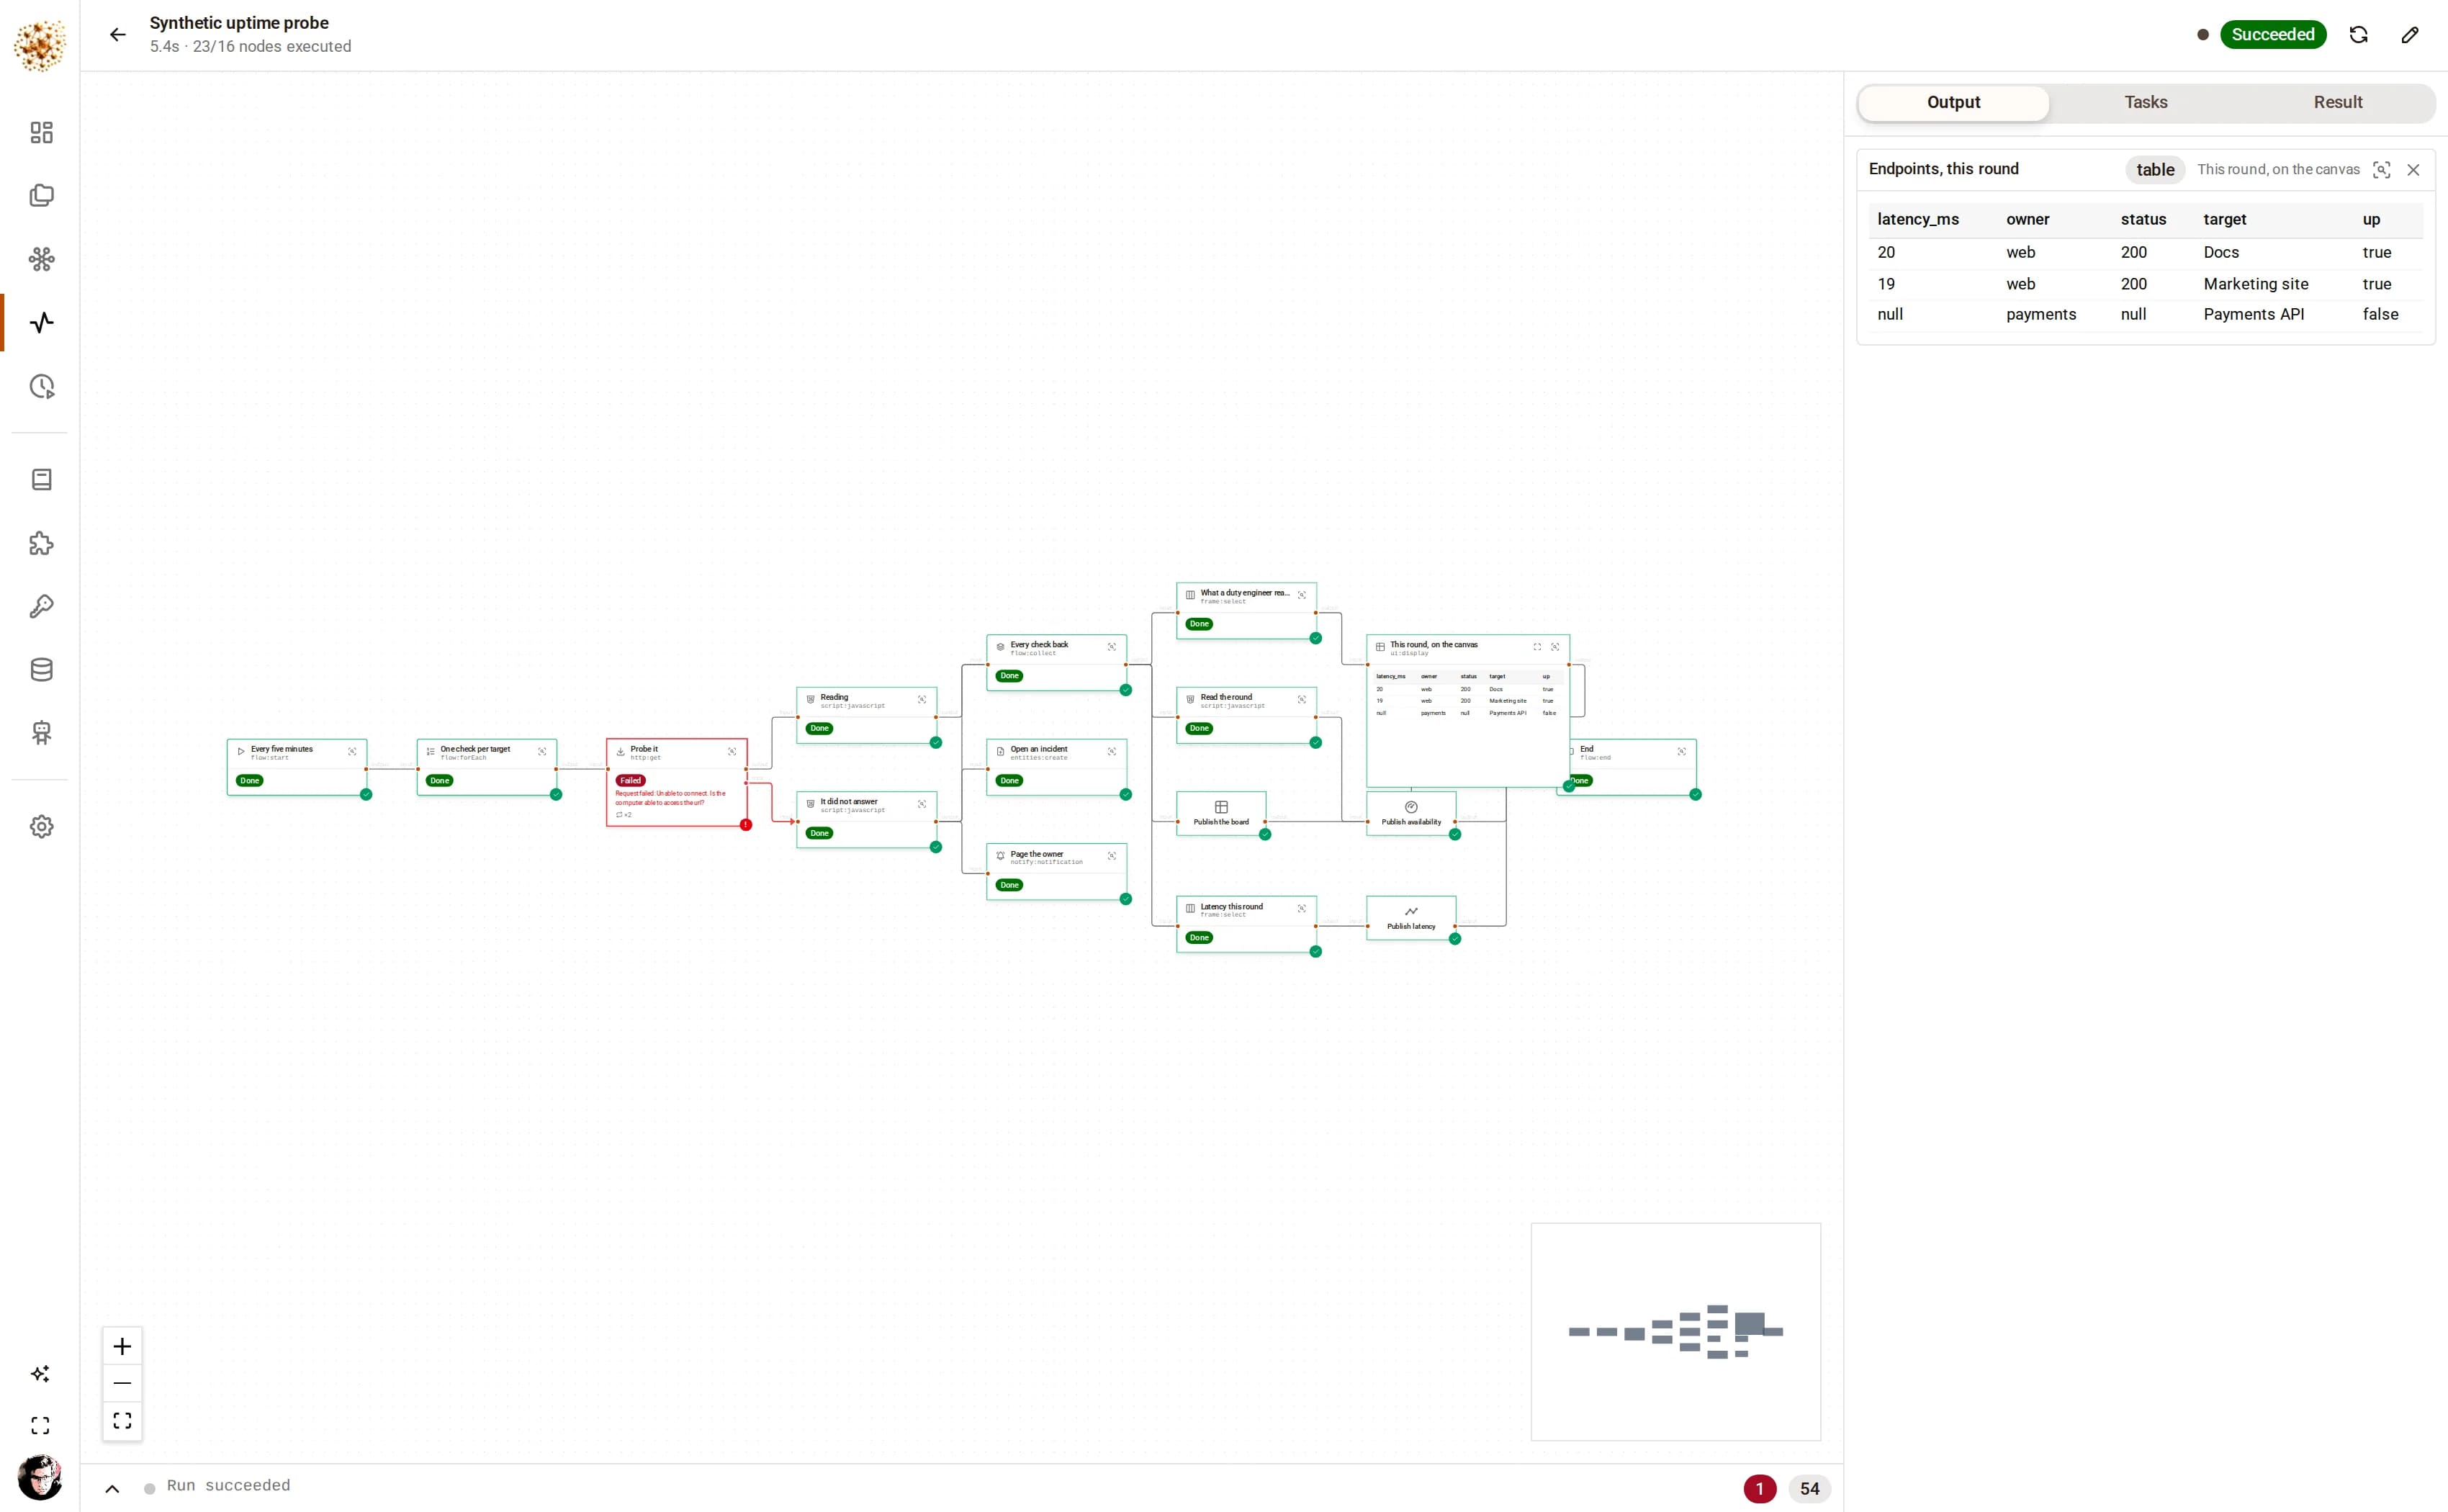
Come funzionano i grafi
Un controllo per endpoint, distribuito a ventaglio
Con retry e backoff su ciascuno.
Un fallimento che diventa un incidente
Un record di incidente e un avviso, non un’esecuzione morta.
Instradamento per gravità e un aggiornamento di stato redatto
E una persona tra la bozza e il pubblico.
L’error budget del mese
Riletto da un database reale, con l’SQL nel nodo.
Sul canvas
http:get · __output_error · flow:approve · sql:sqlite* · views:metric
Viene distribuito con il prodotto
Questo progetto viene distribuito con DjiniousWorkflow. Un comando lo popola, un altro esegue ogni grafo al suo interno, e le schermate qui provengono da quelle esecuzioni.
Dove un grafo si appoggia a un fixture anziché a un sistema live, legge il fixture nel punto in cui il tuo deployment leggerebbe un database — sostituisci il nodo in cima e il resto del grafo non cambia. Il lavoro del motore — il fan-out, la raccolta, l’approvazione, la pubblicazione — è quello proprio del prodotto.
Continua a esplorare
Casi d’uso correlati
 DjiniousDataMaster dataUn’unica vista cliente da quattro sistemi in disaccordoRaggruppa i record che descrivono la stessa organizzazione, e tieni fuori dalla fusione quelli di cui non sei sicuro.DjiniousDataMonitoraggio del sitoContare ciò che una telecamera vede, non ciò che rilevaRilevamento di oggetti su foto, filmati e stream live, materializzato come metriche su cui puoi impostare allerte.DjiniousData