Djinious
DjiniousDataBase de connaissances

Un chiffre sans ses lignesest une opinion.

Plateforme de données API-firstAssignerExploiter

DjiniousData ingère les fichiers, connecteurs et flux que vous avez déjà, les modélise comme votre domaine plutôt que le nôtre, et maintient chaque tuile de tableau de bord, chaque alerte et chaque réponse de l’IA rattachée aux enregistrements dont elle a été calculée. Cliquez sur un constat et vous atterrissez sur la preuve.

DjiniousData
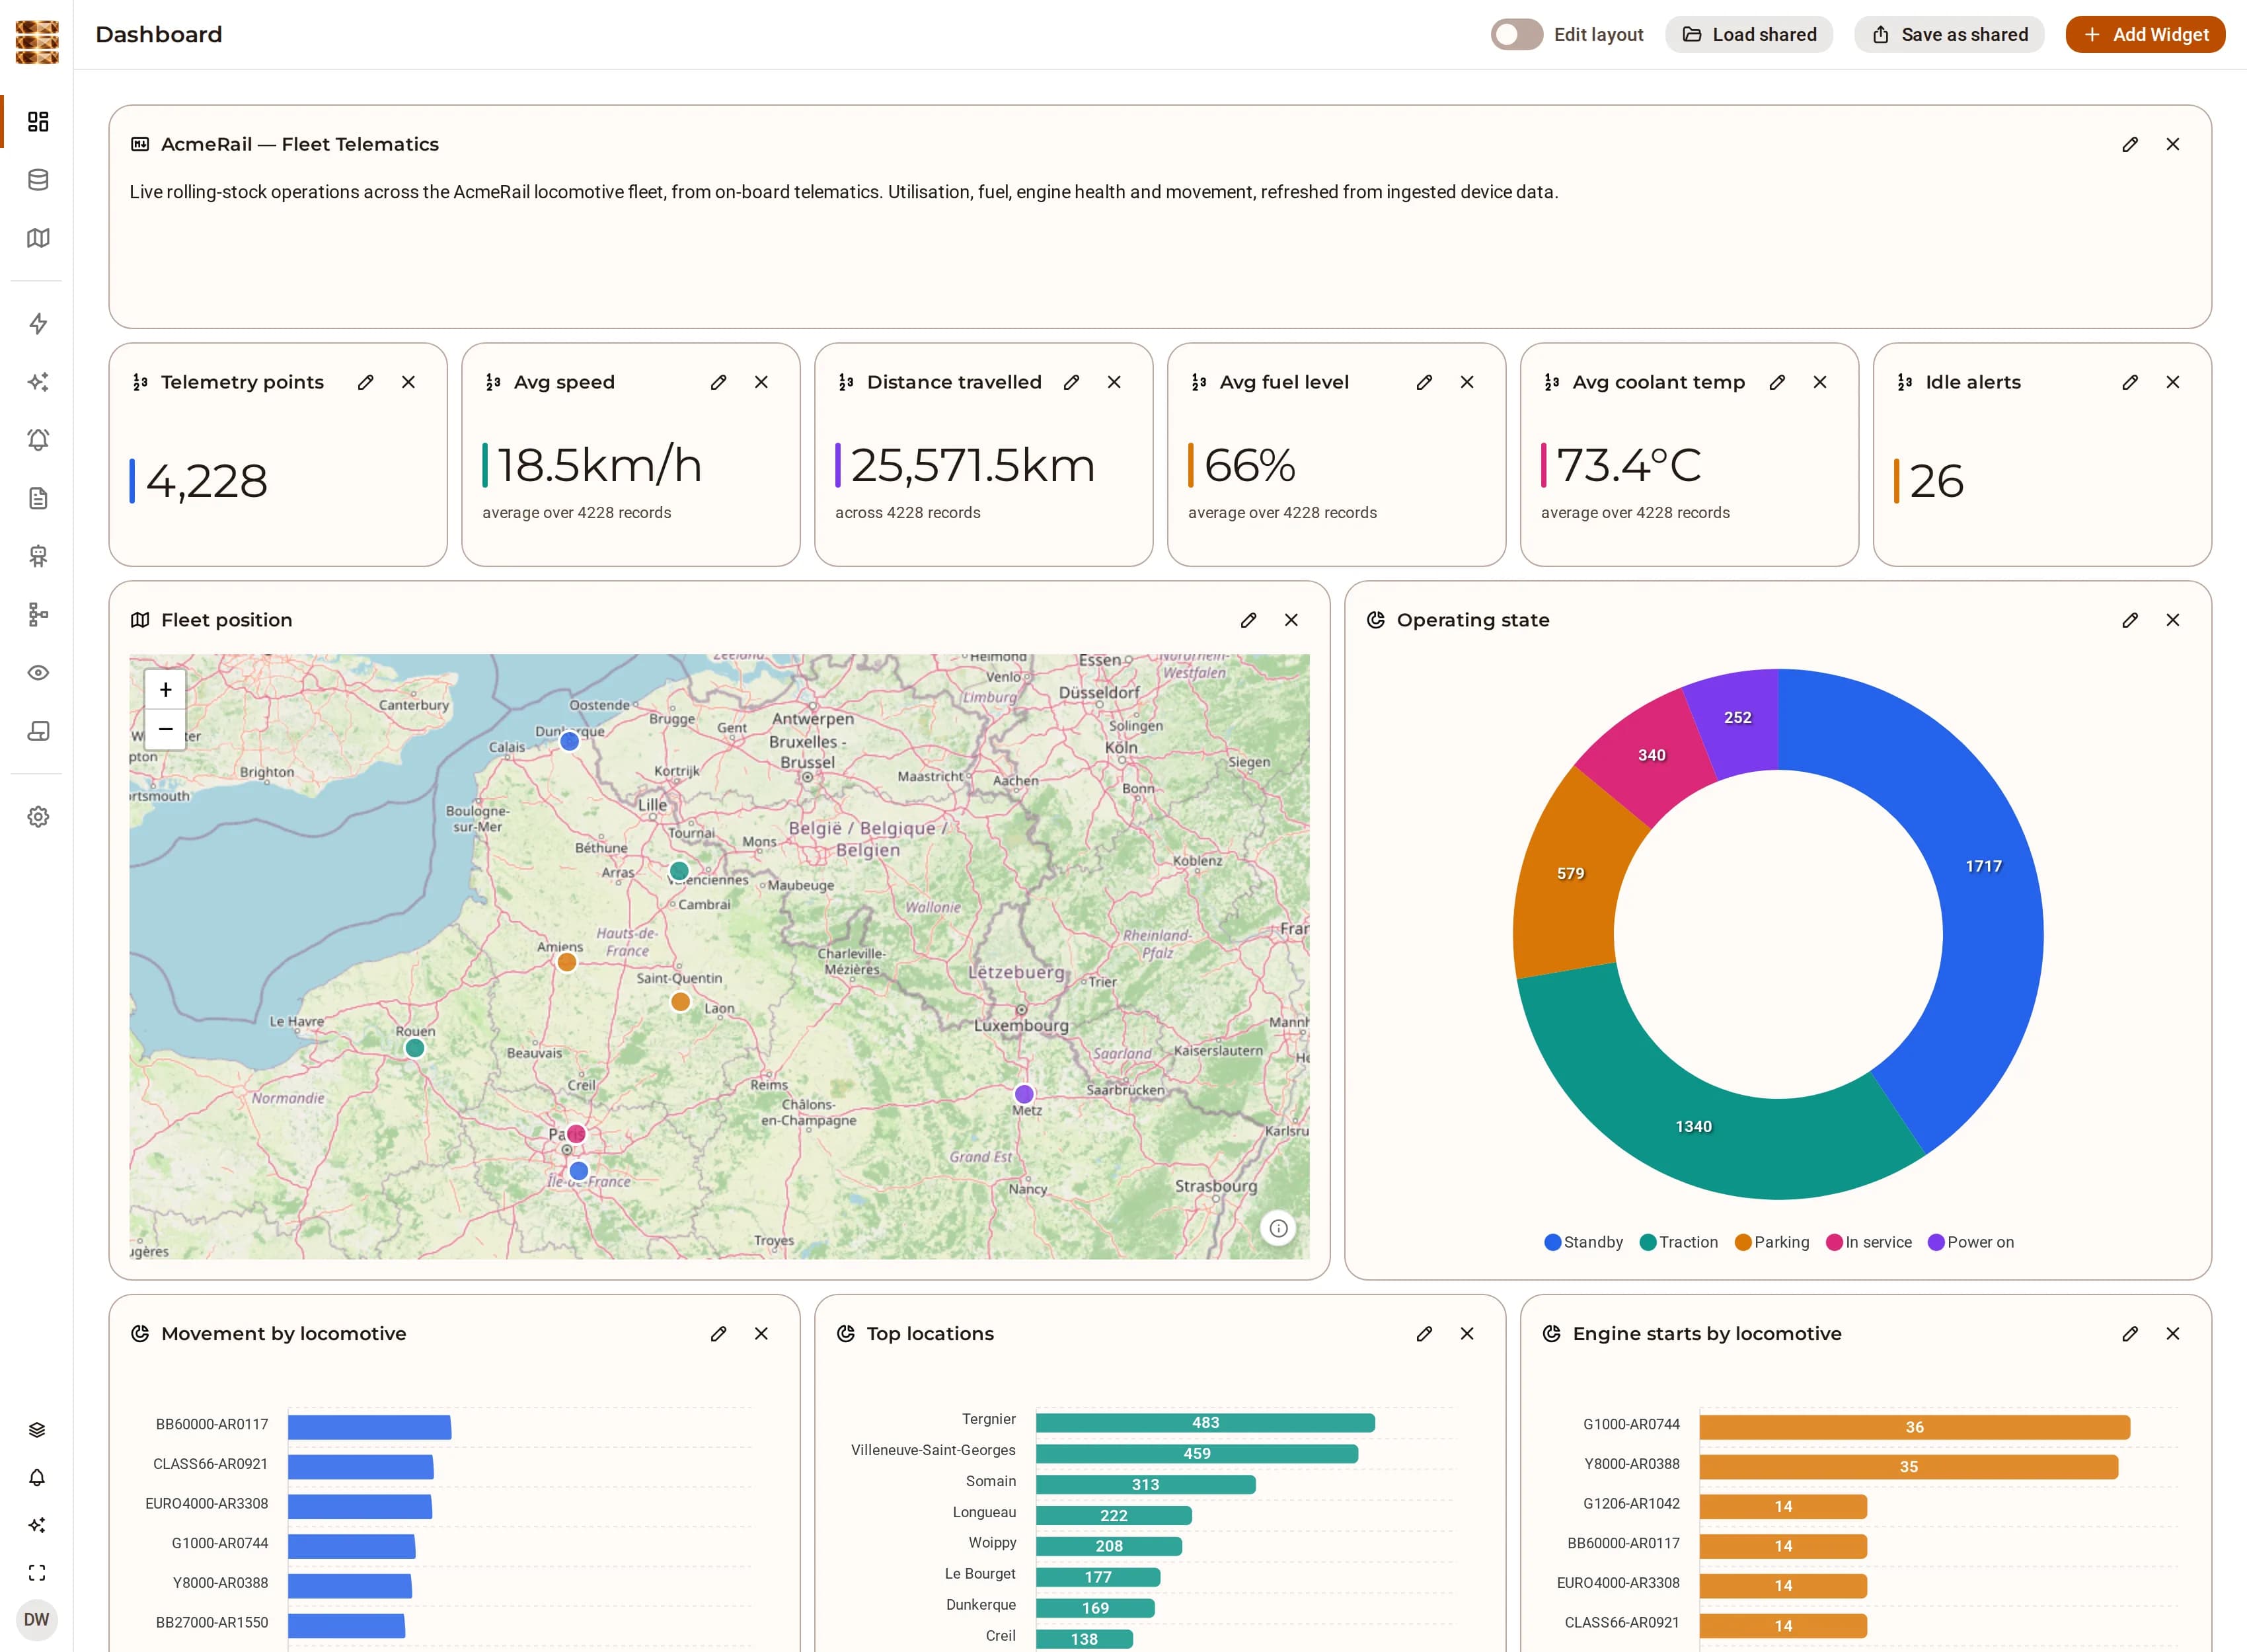
Le tableau de bord de télématique de flotte AcmeRail dans DjiniousData : des tuiles de points de télémétrie, de vitesse, de distance, de carburant, de liquide de refroidissement et d’alertes de ralenti au-dessus d’une carte de flotte en direct du nord de la France et de la Belgique, un anneau d’état de fonctionnement, et des ventilations par locomotive.
Un tableau de bord d’exploitation de flotte assemblé à partir de la télématique ingérée. Chaque tuile est un agrégat en direct sur les enregistrements sous-jacents — pas un instantané stocké — si bien que la carte, la répartition des états et les tendances de santé répondent toutes à partir des mêmes lignes. Pile de développement préchargée, jeu de données AcmeRail.
types d’entités compilés
0types d’entités compilésl’ontologie, ce sont des données, pas du code
étapes d’ingestion, provenance imposée
7étapes d’ingestion, provenance imposéeanalyser · normaliser · dédupliquer · acl · enrichir · vectoriser · persister
outils MCP, la même authentification que l’interface
46outils MCP, la même authentification que l’interfacejetons API à portée définie · pas de porte dérobée
la ligne entre fusionné et candidat
0.85la ligne entre fusionné et candidaten dessous, une correspondance attend un analyste

Ce que c’est

Une seule plateforme pour l’ingestion, le modèle, le graphe et la réponse

La plupart des piles de données sont quatre produits cousus ensemble : quelque chose qui charge, quelque chose qui modélise, quelque chose qui trace des graphiques, et quelque chose qui, enfin, laisse une IA s’en approcher. Chacun conserve sa propre copie de qui peut voir quoi, et la généalogie des données meurt à chaque couture. DjiniousData est un seul plan de contrôle API-first, et chaque capacité existe comme un point de terminaison avant d’exister comme un écran.

Ingestion unifiée

CSV, Excel, PDF, DOCX, JSON et Markdown depuis le magasin de documents ; systèmes externes via des plugins connecteurs ; vidéo et caméra en direct via le pipeline de vision. Tout arrive sous forme d’objet de connaissance portant sa propre provenance, et un objet dont la provenance ne se valide pas est refusé plutôt que stocké.

fichiers · connecteurs · plugins · flux

Ontologie à l’exécution

Les types d’entités et de relations sont définis via l’interface ou l’API et stockés dans la base de données — pas déclarés dans un fichier de schéma et livrés dans une version. Une organisation peut superposer ses propres champs, libellés et flux de statuts à un type de base partagé sans le forker.

types d’entités · types de relations · surcouches par organisation

Enrichissement offline-first

Les entités, mots-clés, sujets, sentiments et langues sont extraits par un enrichisseur déterministe hors ligne qui ne nécessite ni modèle ni réseau. Un LLM améliore le résultat quand l’un d’eux est configuré ; il ne se dresse jamais entre vos données et leur exploitabilité.

déterministe, avec le LLM comme accélérateur

Résolution d’entités

Les enregistrements qui décrivent la même chose sont regroupés par blocking et notation par paires. Au-dessus de 0,85, la plateforme fusionne ; entre 0,7 et 0,85, elle retient la paire comme candidate pour un humain, et enregistre la décision de l’analyste pour que l’exécution suivante la respecte.

identifiant 1,0 · nom exact 0,85 · flou 0,7

Graphe de connaissances

Les entités résolues sont reliées en un graphe navigable dont les arêtes portent les objets dont elles sont dérivées. Le parcours est restreint par les ACL avant de renvoyer un voisin, si bien que le graphe ne peut pas devenir un chemin de contournement des permissions.

des arêtes avec des preuves, pas seulement des flèches

Tableaux de bord, alertes et rapports

Les widgets interrogent directement les objets sous-jacents, si bien qu’une tuile est toujours à jour et toujours traçable. Les règles d’alerte surveillent un agrégat d’un champ par groupe et se déclenchent sur un seuil. Les rapports citent les lignes derrière chaque section.

des agrégats sur les enregistrements, calculés à la lecture

Dans le produit

Voyez-la fonctionner.

Chaque capture ci-dessous est le produit en fonctionnement.

01 · Ingérer

Chaque ligne devient un objet qui sait d’où il vient

Pointez la plateforme vers un dossier de documents, un connecteur ou une caméra. Chaque ligne, page ou exécution devient un objet de connaissance : analysé, normalisé, dédupliqué sur un hachage de contenu, mappé en permissions, enrichi, vectorisé et persisté — avec le système source, l’identifiant de l’objet source et l’heure d’ingestion enregistrés au passage.

  • CSV, XLS/XLSX, PDF, DOCX, JSON, Markdown et texte brut, un objet par ligne tabulaire
  • Les colonnes numériques sont aussi diffusées vers un magasin de séries temporelles, si bien que les graphiques de télémétrie et les règles de seuil travaillent sur le même chargement
  • La déduplication se fait par hachage de contenu par rapport à l’identifiant d’objet propre à la source — réingérer un fichier est sans effet, pas une seconde copie
DjiniousData
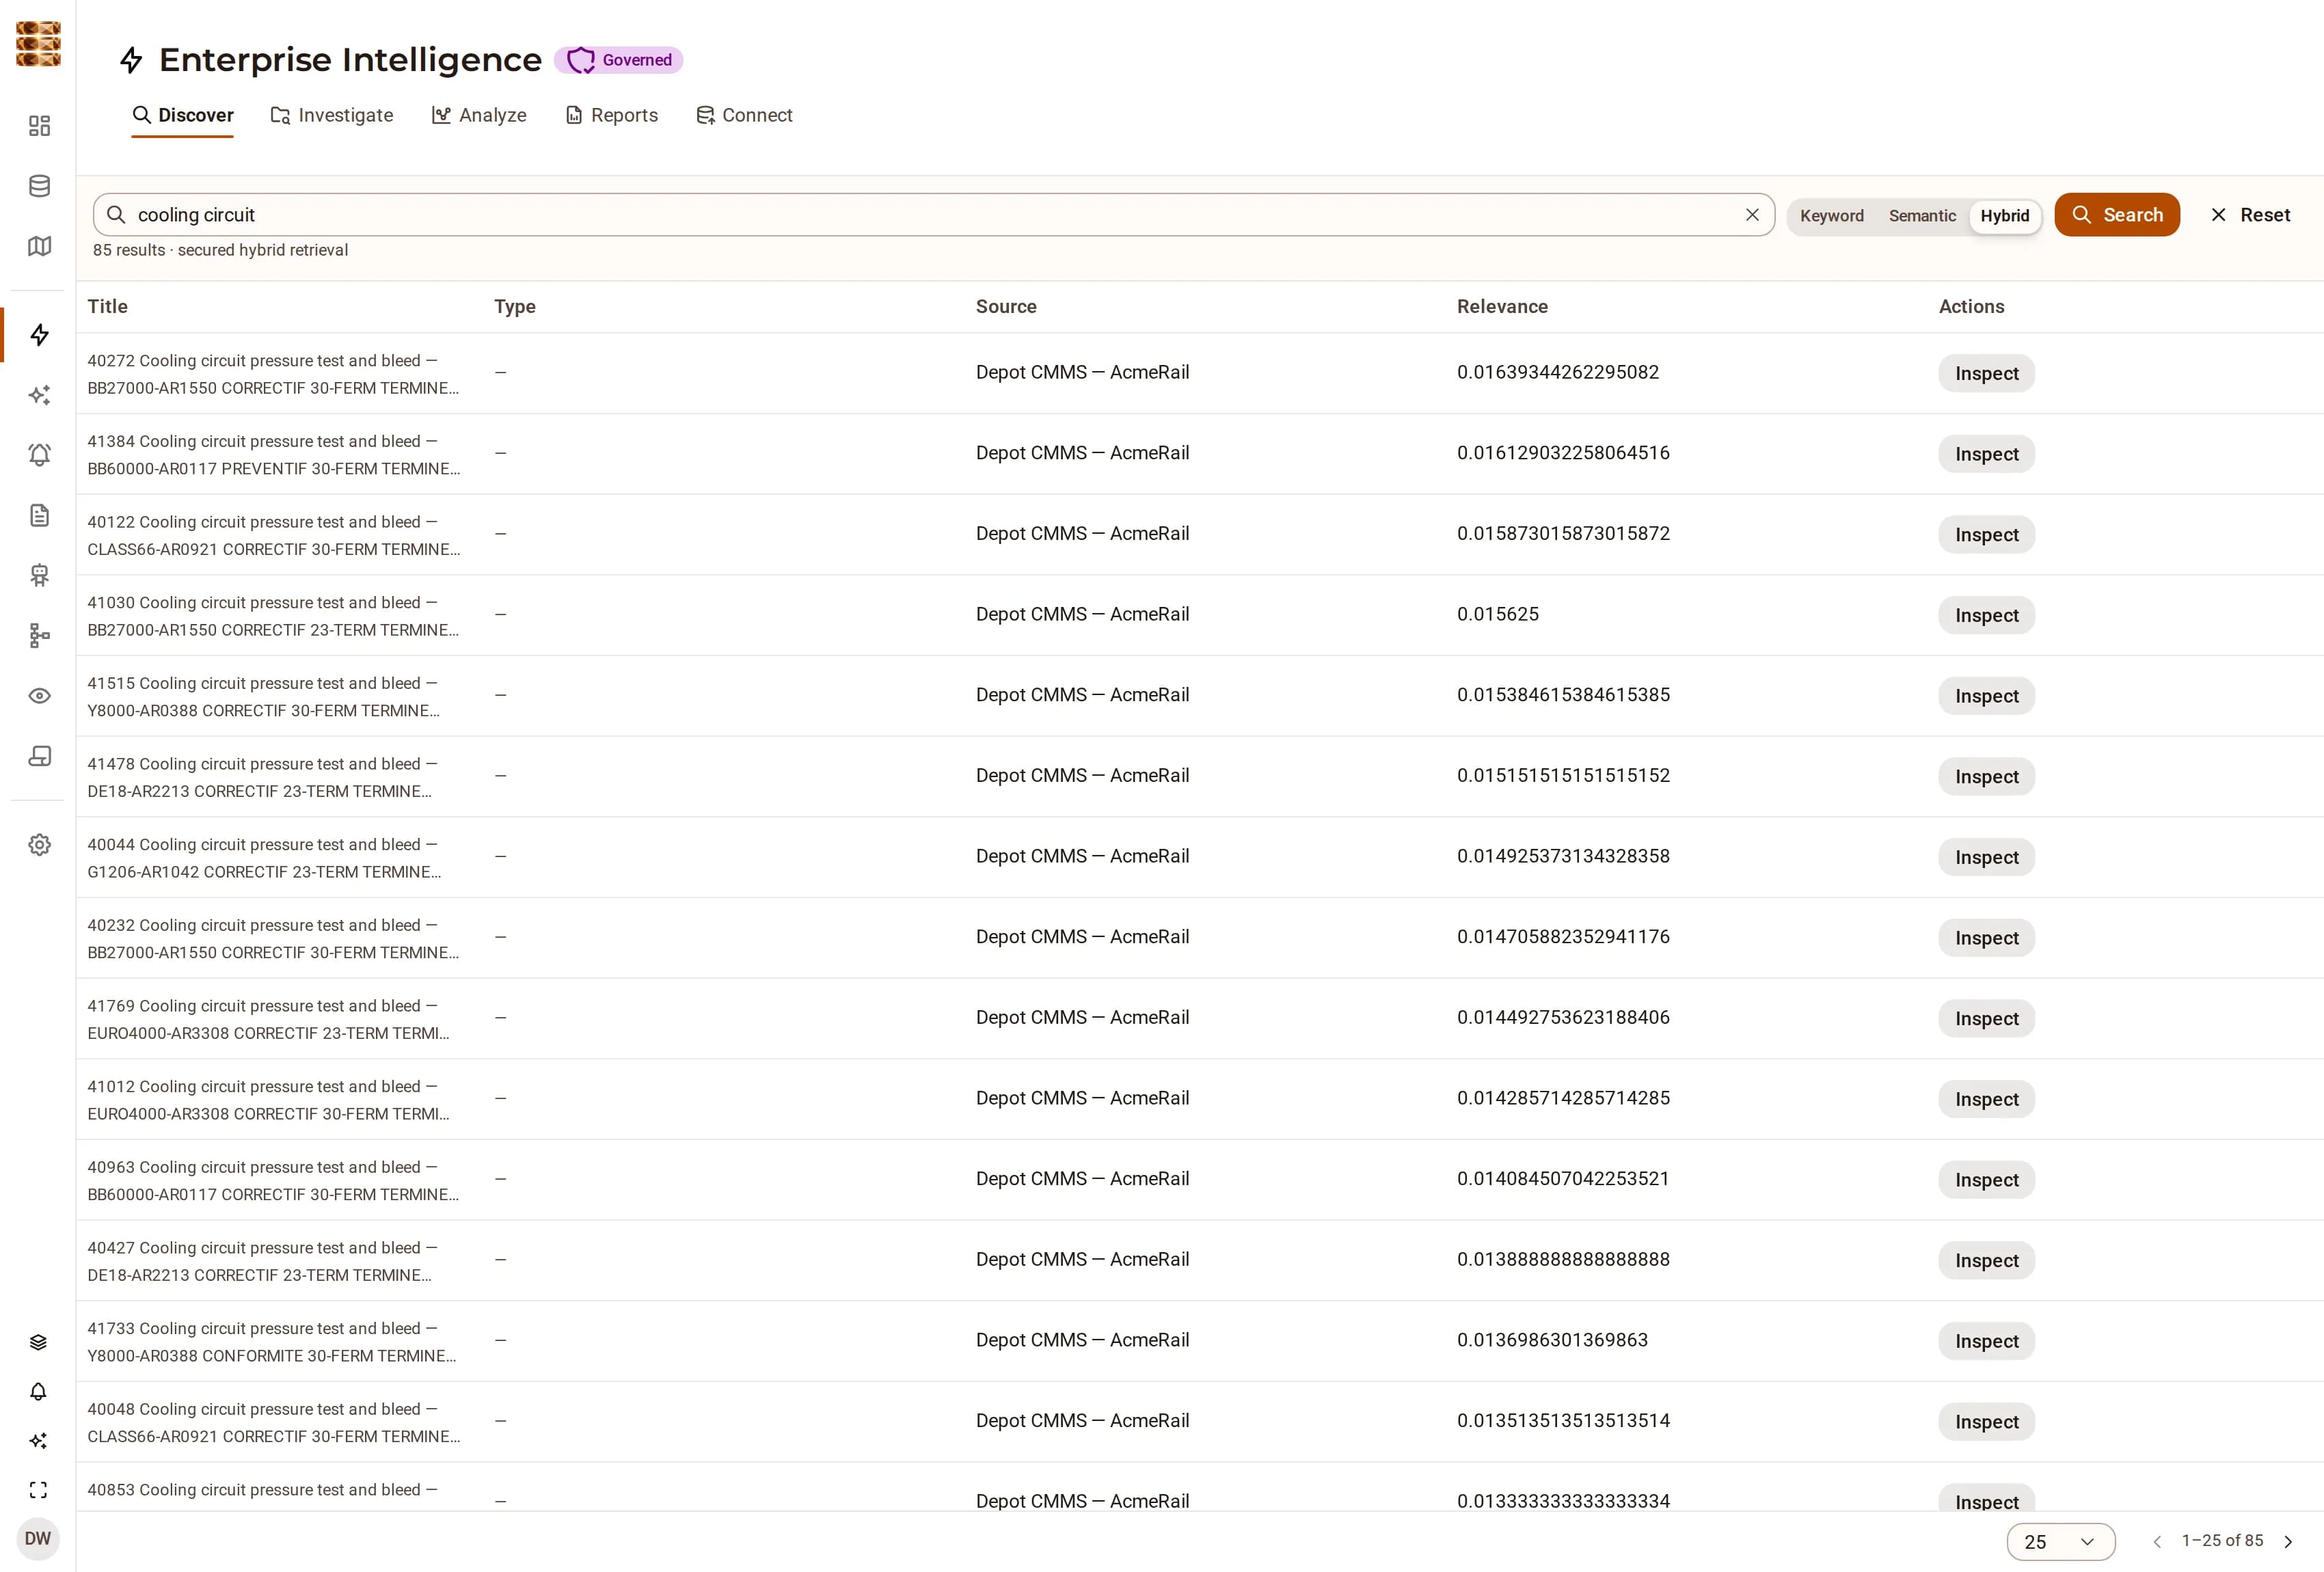
Résultats de recherche DjiniousData pour une locomotive : des lignes de télémétrie ingérée, chacune portant son nom de source, son score de pertinence et une action Inspecter.
Ce que produit l’ingestion, quelle que soit la porte par laquelle les données sont arrivées : un objet consultable par ligne, portant la source dont il vient et s’ouvrant sur l’enregistrement lui-même.

02 · Modéliser

Décrivez votre domaine, et la plateforme se construit autour

Décrivez votre domaine sous forme de types d’entités et de types de relations — champs, libellés, icônes, un flux de statuts — et la plateforme construit autour le CRUD, les vues de liste, les pages de détail, les facettes de recherche et les outils agent. Aucune migration, aucun déploiement, aucun code.

  • Les types sont des enregistrements stockés : créez-en un à 11 h 00 et sa vue de liste existe à 11 h 00
  • Les surcouches par organisation superposent des champs et des flux à un type de base partagé sans le forker
  • L’assistant IA peut proposer un type à partir des données qu’il a ingérées, et vous approuvez ou rejetez la proposition
DjiniousData
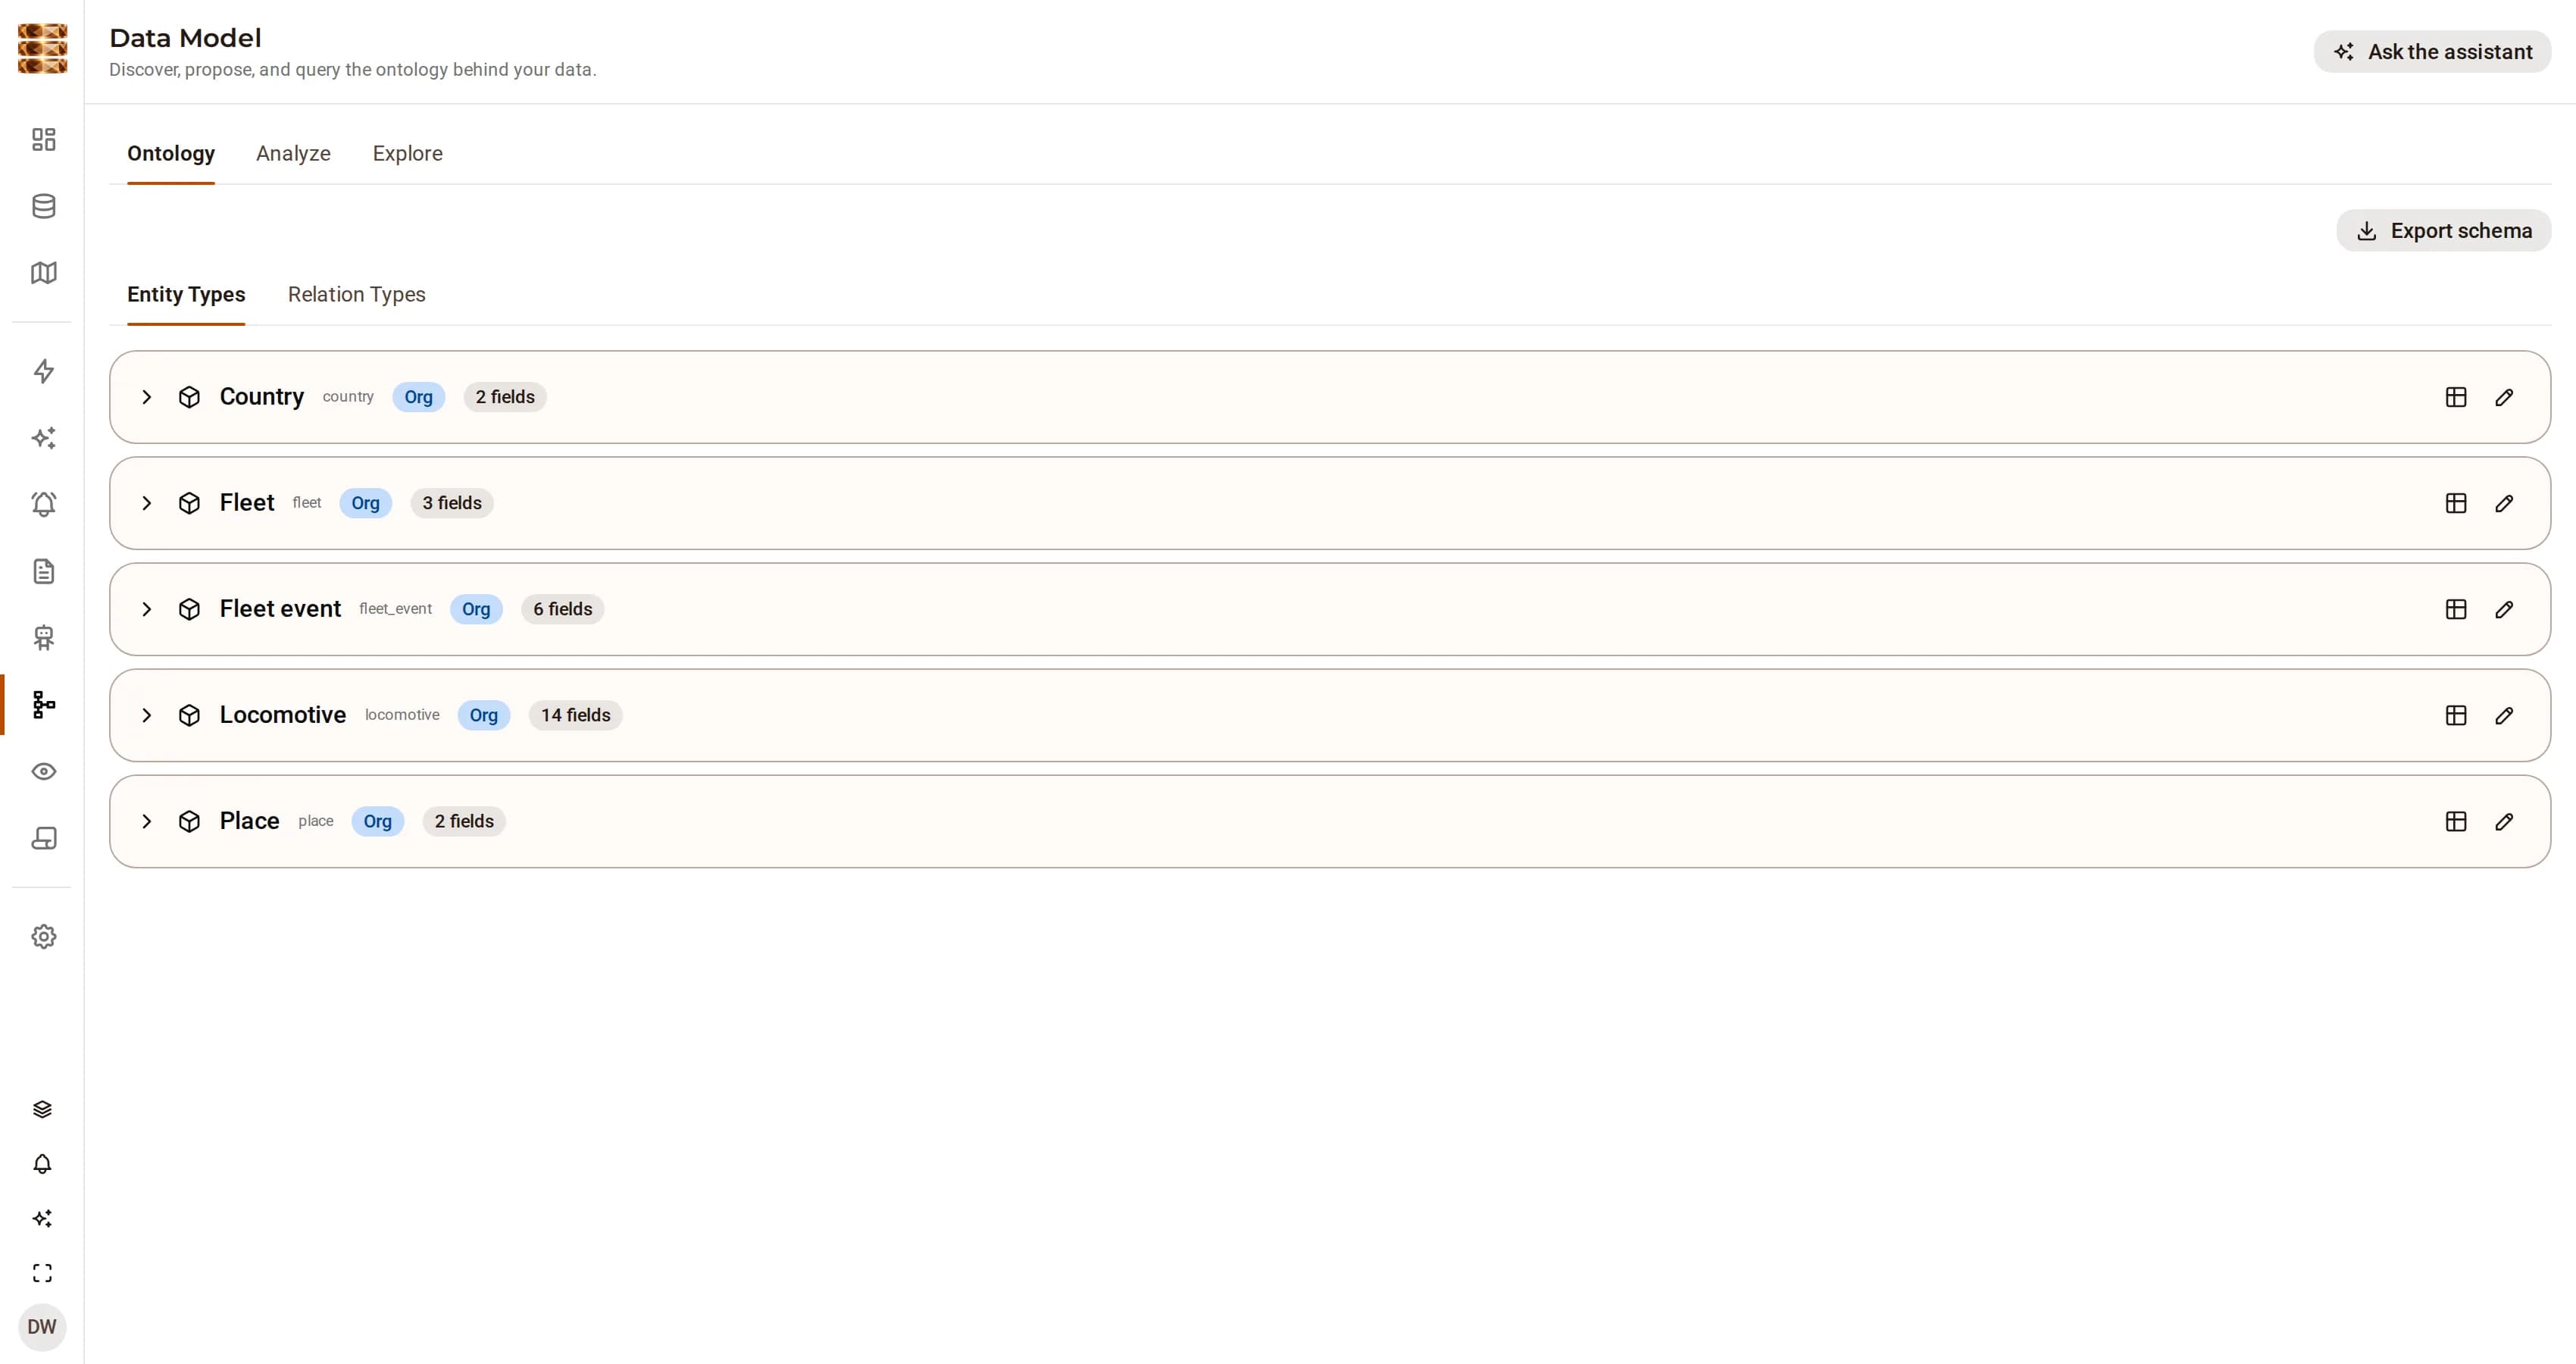
La page de modèle de données DjiniousData listant les cinq types d’entités d’AcmeRail — pays, flotte, événement de flotte, locomotive et lieu — chacun estampillé comme appartenant à l’organisation.
Cinq types, définis à l’exécution et appartenant à l’organisation plutôt qu’à la plateforme. Chacun a reçu sa vue de liste, sa page de détail et ses outils agent sans qu’une seule ligne n’ait été écrite pour lui.

03 · Résoudre

Regroupez ce qui est identique, et gardez la preuve sur l’arête

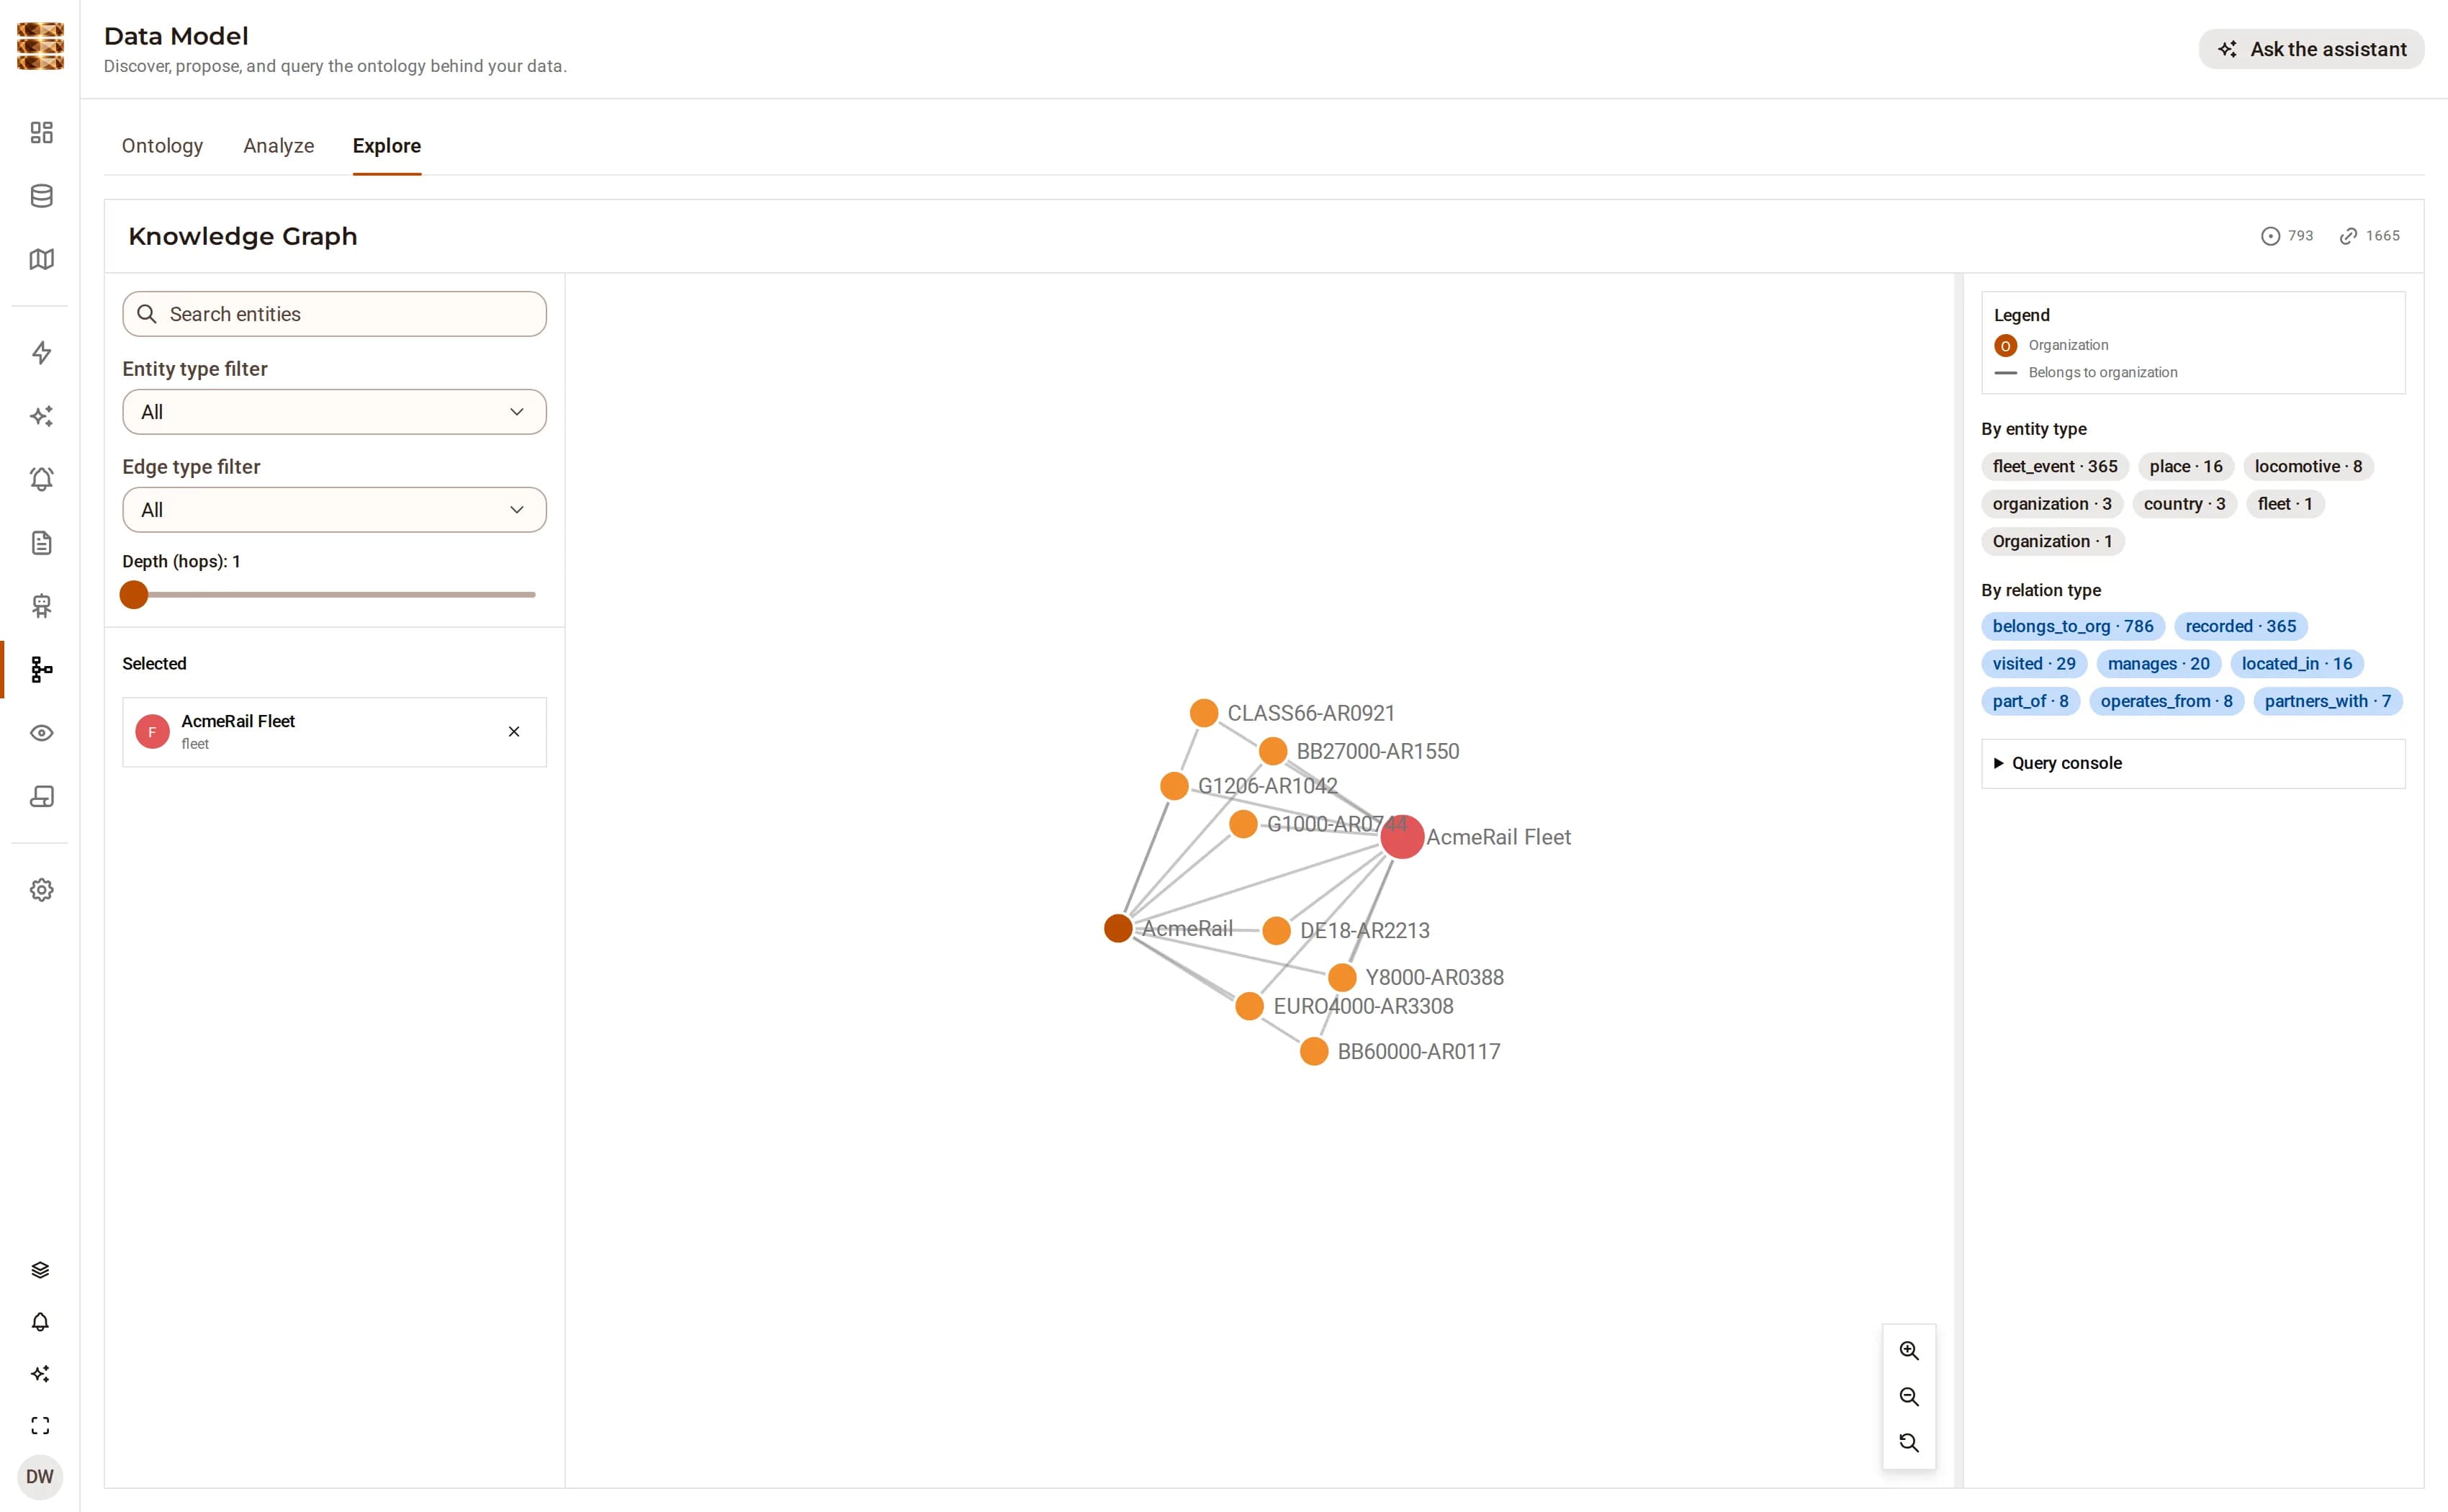
Regroupez les enregistrements qui décrivent la même chose réelle, reliez les groupes en un graphe, et gardez la preuve sur l’arête. Chaque entité est aussi reliée à l’organisation qui la possède, comme une relation dérivée que la plateforme synthétise plutôt qu’une arête stockée qu’il faudrait penser à écrire.

  • Blocking, notation par paires et regroupement union-find, le tout hors ligne et déterministe
  • Les correspondances floues en dessous de la ligne de fusion automatique restent candidates, et la décision d’un analyste est respectée à l’exécution suivante
  • Le parcours du graphe est restreint par les ACL avant de renvoyer un voisin, pas filtré après
DjiniousData
L’explorateur de graphe de connaissances DjiniousData montrant le nœud de la flotte AcmeRail connecté à ses huit locomotives et à l’organisation AcmeRail.
La flotte, ses huit unités et l’organisation à laquelle elles appartiennent. L’arête vers l’organisation est dérivée de l’enregistrement plutôt que stockée, si bien qu’elle ne peut pas se désynchroniser de lui.

04 · Signaux

Des constats qui arrivent avec leur preuve jointe

L’analyse produit des signaux — anomalies, motifs, signaux faibles — chacun avec un sujet, une méthode, un niveau de confiance et des références aux objets de connaissance dont il a été calculé. La sévérité est dérivée de la confiance plutôt qu’assignée, si bien que deux constats à la même confiance ne peuvent pas être classés différemment selon qui les a rédigés.

  • Les résumés de signaux interpolent des agrégats mesurés, jamais des chiffres codés en dur
  • Chaque signal porte des références aux objets de connaissance dont il est tiré
  • Une seule recherche sur les entités, documents, événements et analyses — par mot-clé, sémantique ou hybride — chaque résultat s’ouvrant sur l’enregistrement qui le sous-tend
DjiniousData
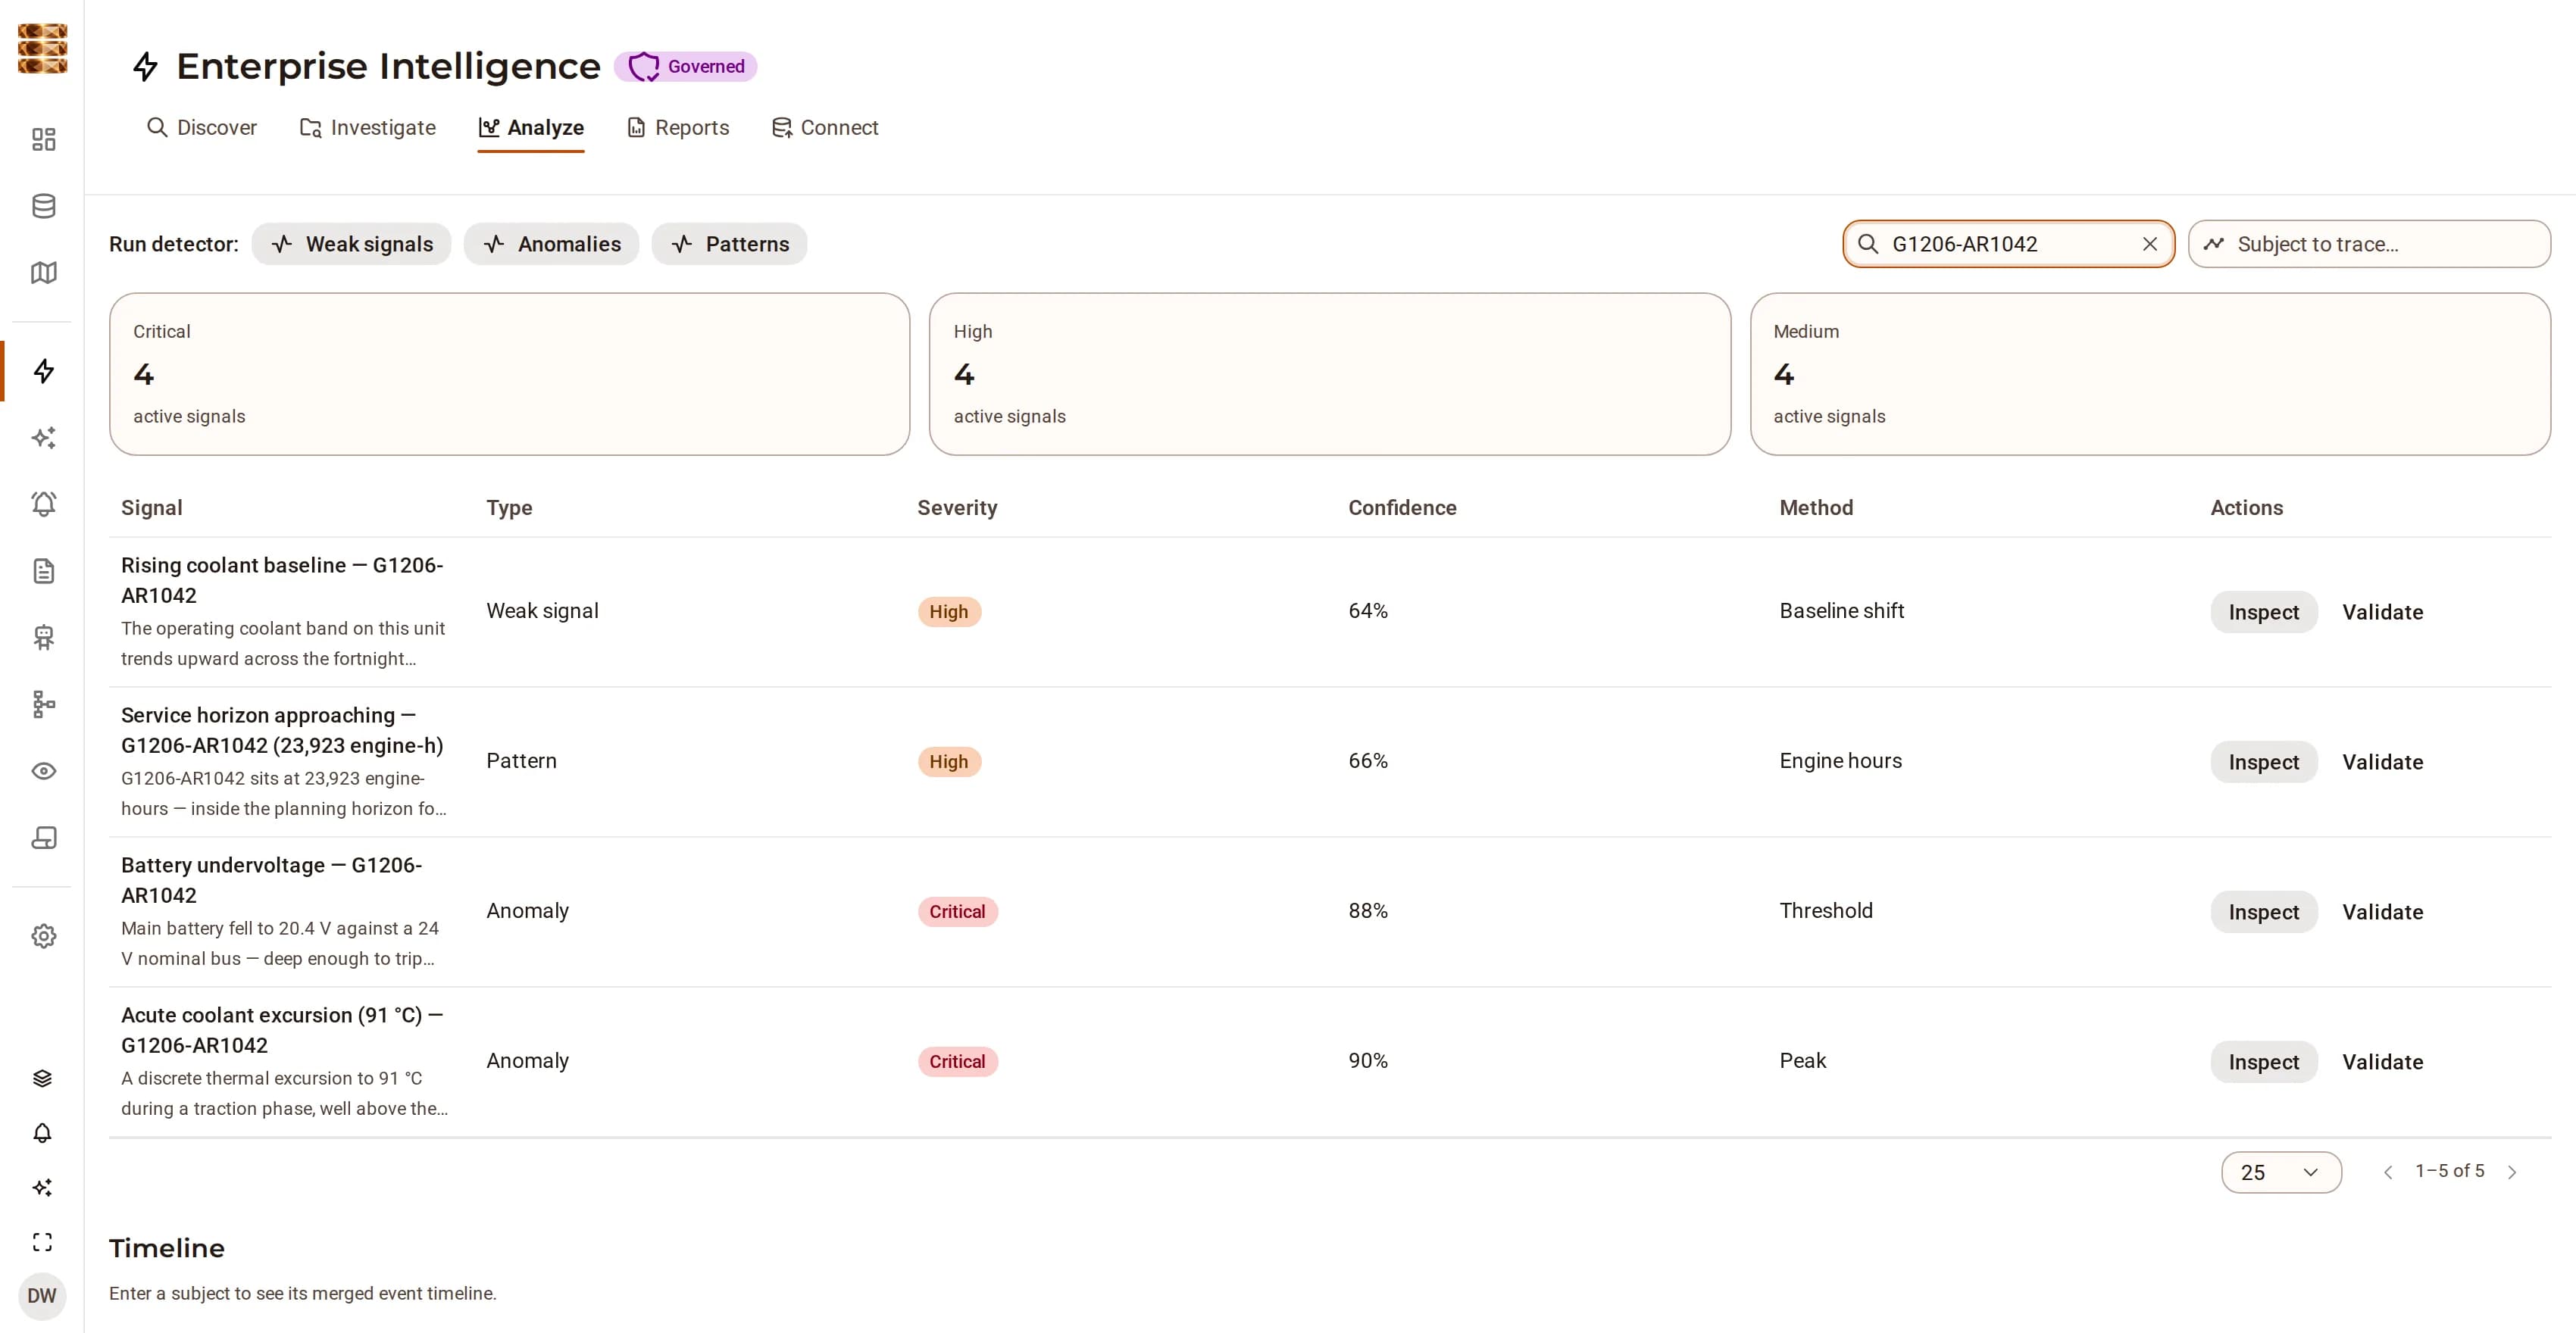
La vue Analyser de DjiniousData, filtrée sur la locomotive G1206-AR1042 : cinq constats — dont trois critiques — chacun avec son type, sa sévérité, sa confiance, sa méthode et une action Inspecter, au-dessus d’un résumé de sévérité de toute la flotte.
Douze constats sur deux semaines de télémétrie de flotte, filtrés ici sur une locomotive. La sévérité est dérivée de la confiance plutôt qu’assignée, et chaque ligne s’ouvre sur les relevés qui la sous-tendent.

05 · Du constat à l’action

Une règle qui se déclenche est le début du fil, pas sa fin

Une alerte sans dossier est une notification que quelqu’un finit par ne plus lire. Le chemin de la plateforme fonctionne dans l’autre sens : la règle se déclenche, le signal explique ce qui a été mesuré et ce que cela implique, le dossier rassemble les preuves et assigne un responsable, et c’est le rapport qui quitte les murs.

  • Les règles d’alerte se déclenchent sur un maximum, un minimum, une moyenne ou un dénombrement d’un champ autorisé sur une source, par groupe
  • L’historique des alertes conserve la valeur observée et le seuil à côté de chaque déclenchement, si bien qu’une règle trop sensible se voit comme telle
  • Les dossiers portent des collaborateurs, des tags, des commentaires et une piste d’activité, et leurs éléments de preuve conservent leurs références vers les objets source
DjiniousData
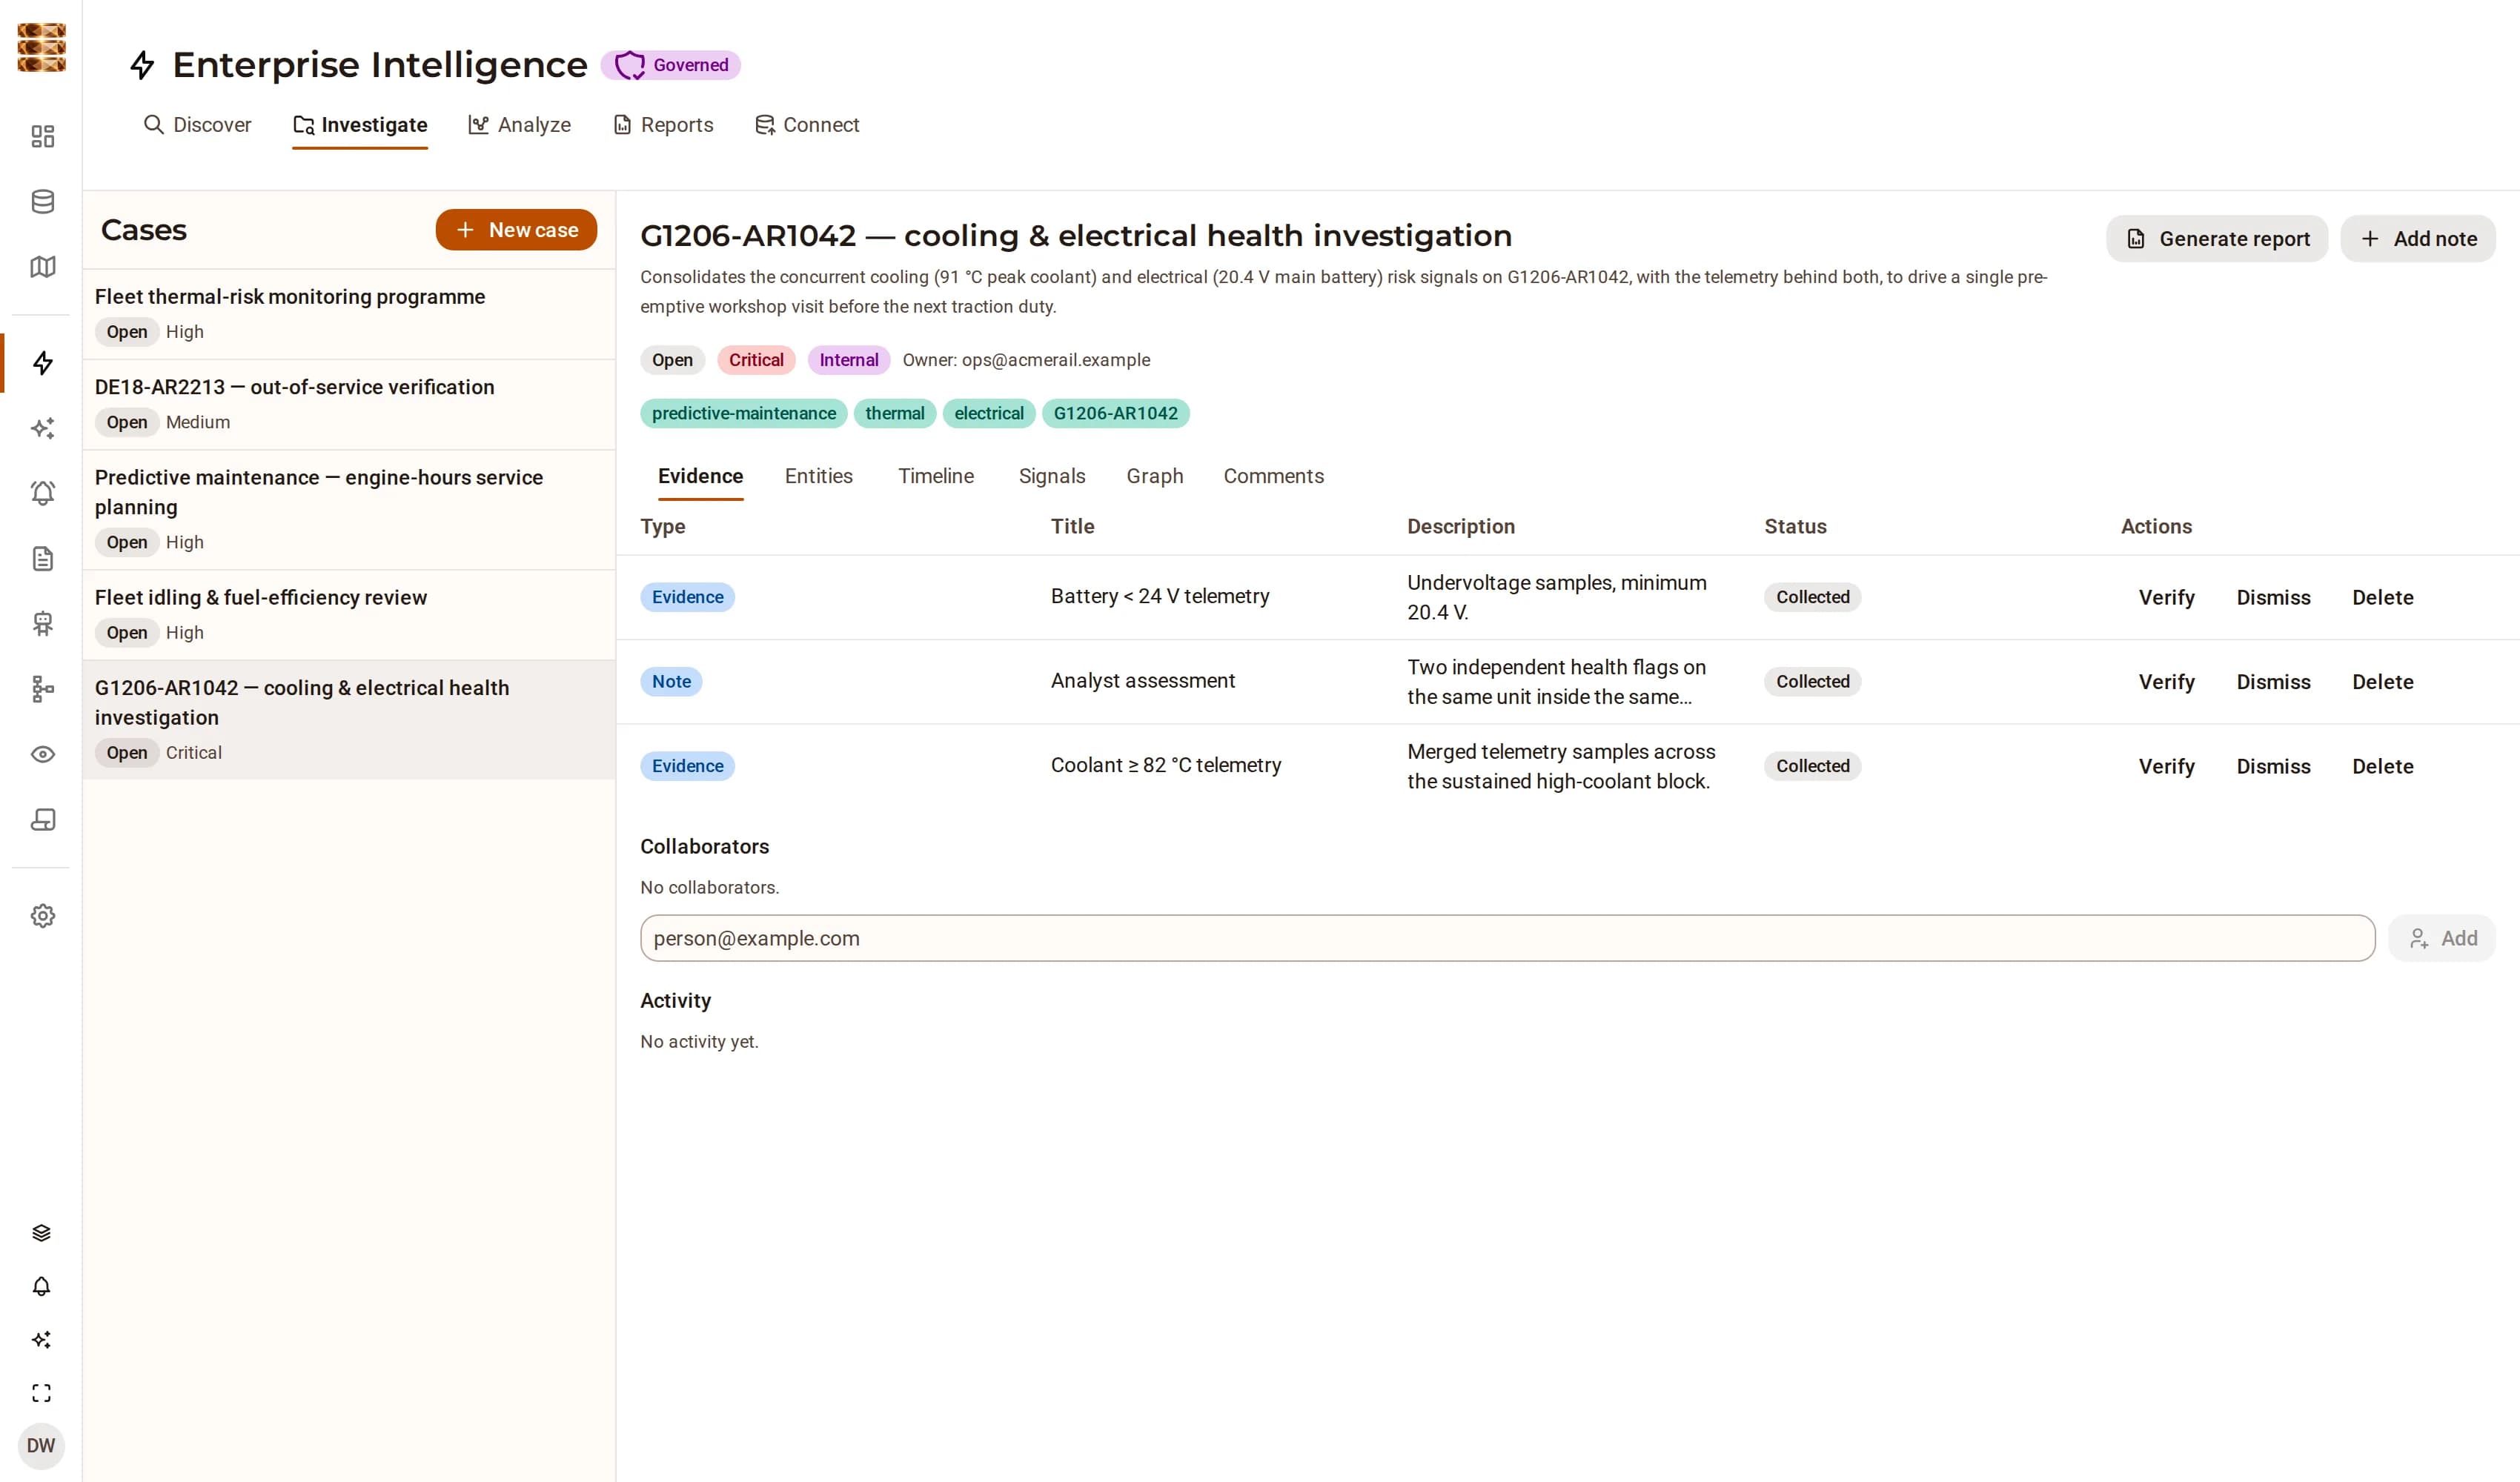
Un dossier d’enquête ouvert pour la locomotive G1206-AR1042 consolidant ses signaux de risque de refroidissement et électrique, avec trois éléments de preuve rassemblés, ses tags, son responsable et sa piste d’activité.
Le dossier qui consolide les deux signaux de santé concurrents de la flotte sur une même unité. Ses éléments de preuve conservent leurs références aux lignes de télémétrie dont les signaux ont été calculés.

06 · Rapports

Un chiffre dans un rapport et la tuile dont il provient ne peuvent pas se contredire

Des rapports structurés dont les sections sont typées — narratif, entités, signaux — et dont les citations pointent vers des enregistrements plutôt que vers d’autre prose. Un rapport est généré à partir de l’état de la plateforme, et peut être généré à partir d’un dossier, en conservant le lien vers celui-ci. L’export PDF et Excel lit les mêmes enregistrements que ceux que lit l’écran.

  • Des sections typées, avec des citations vers les objets source
  • Les rapports générés à partir d’un dossier conservent le lien vers celui-ci
  • L’API n’est pas un sous-ensemble de l’interface ; l’interface est une consommatrice de l’API
DjiniousData
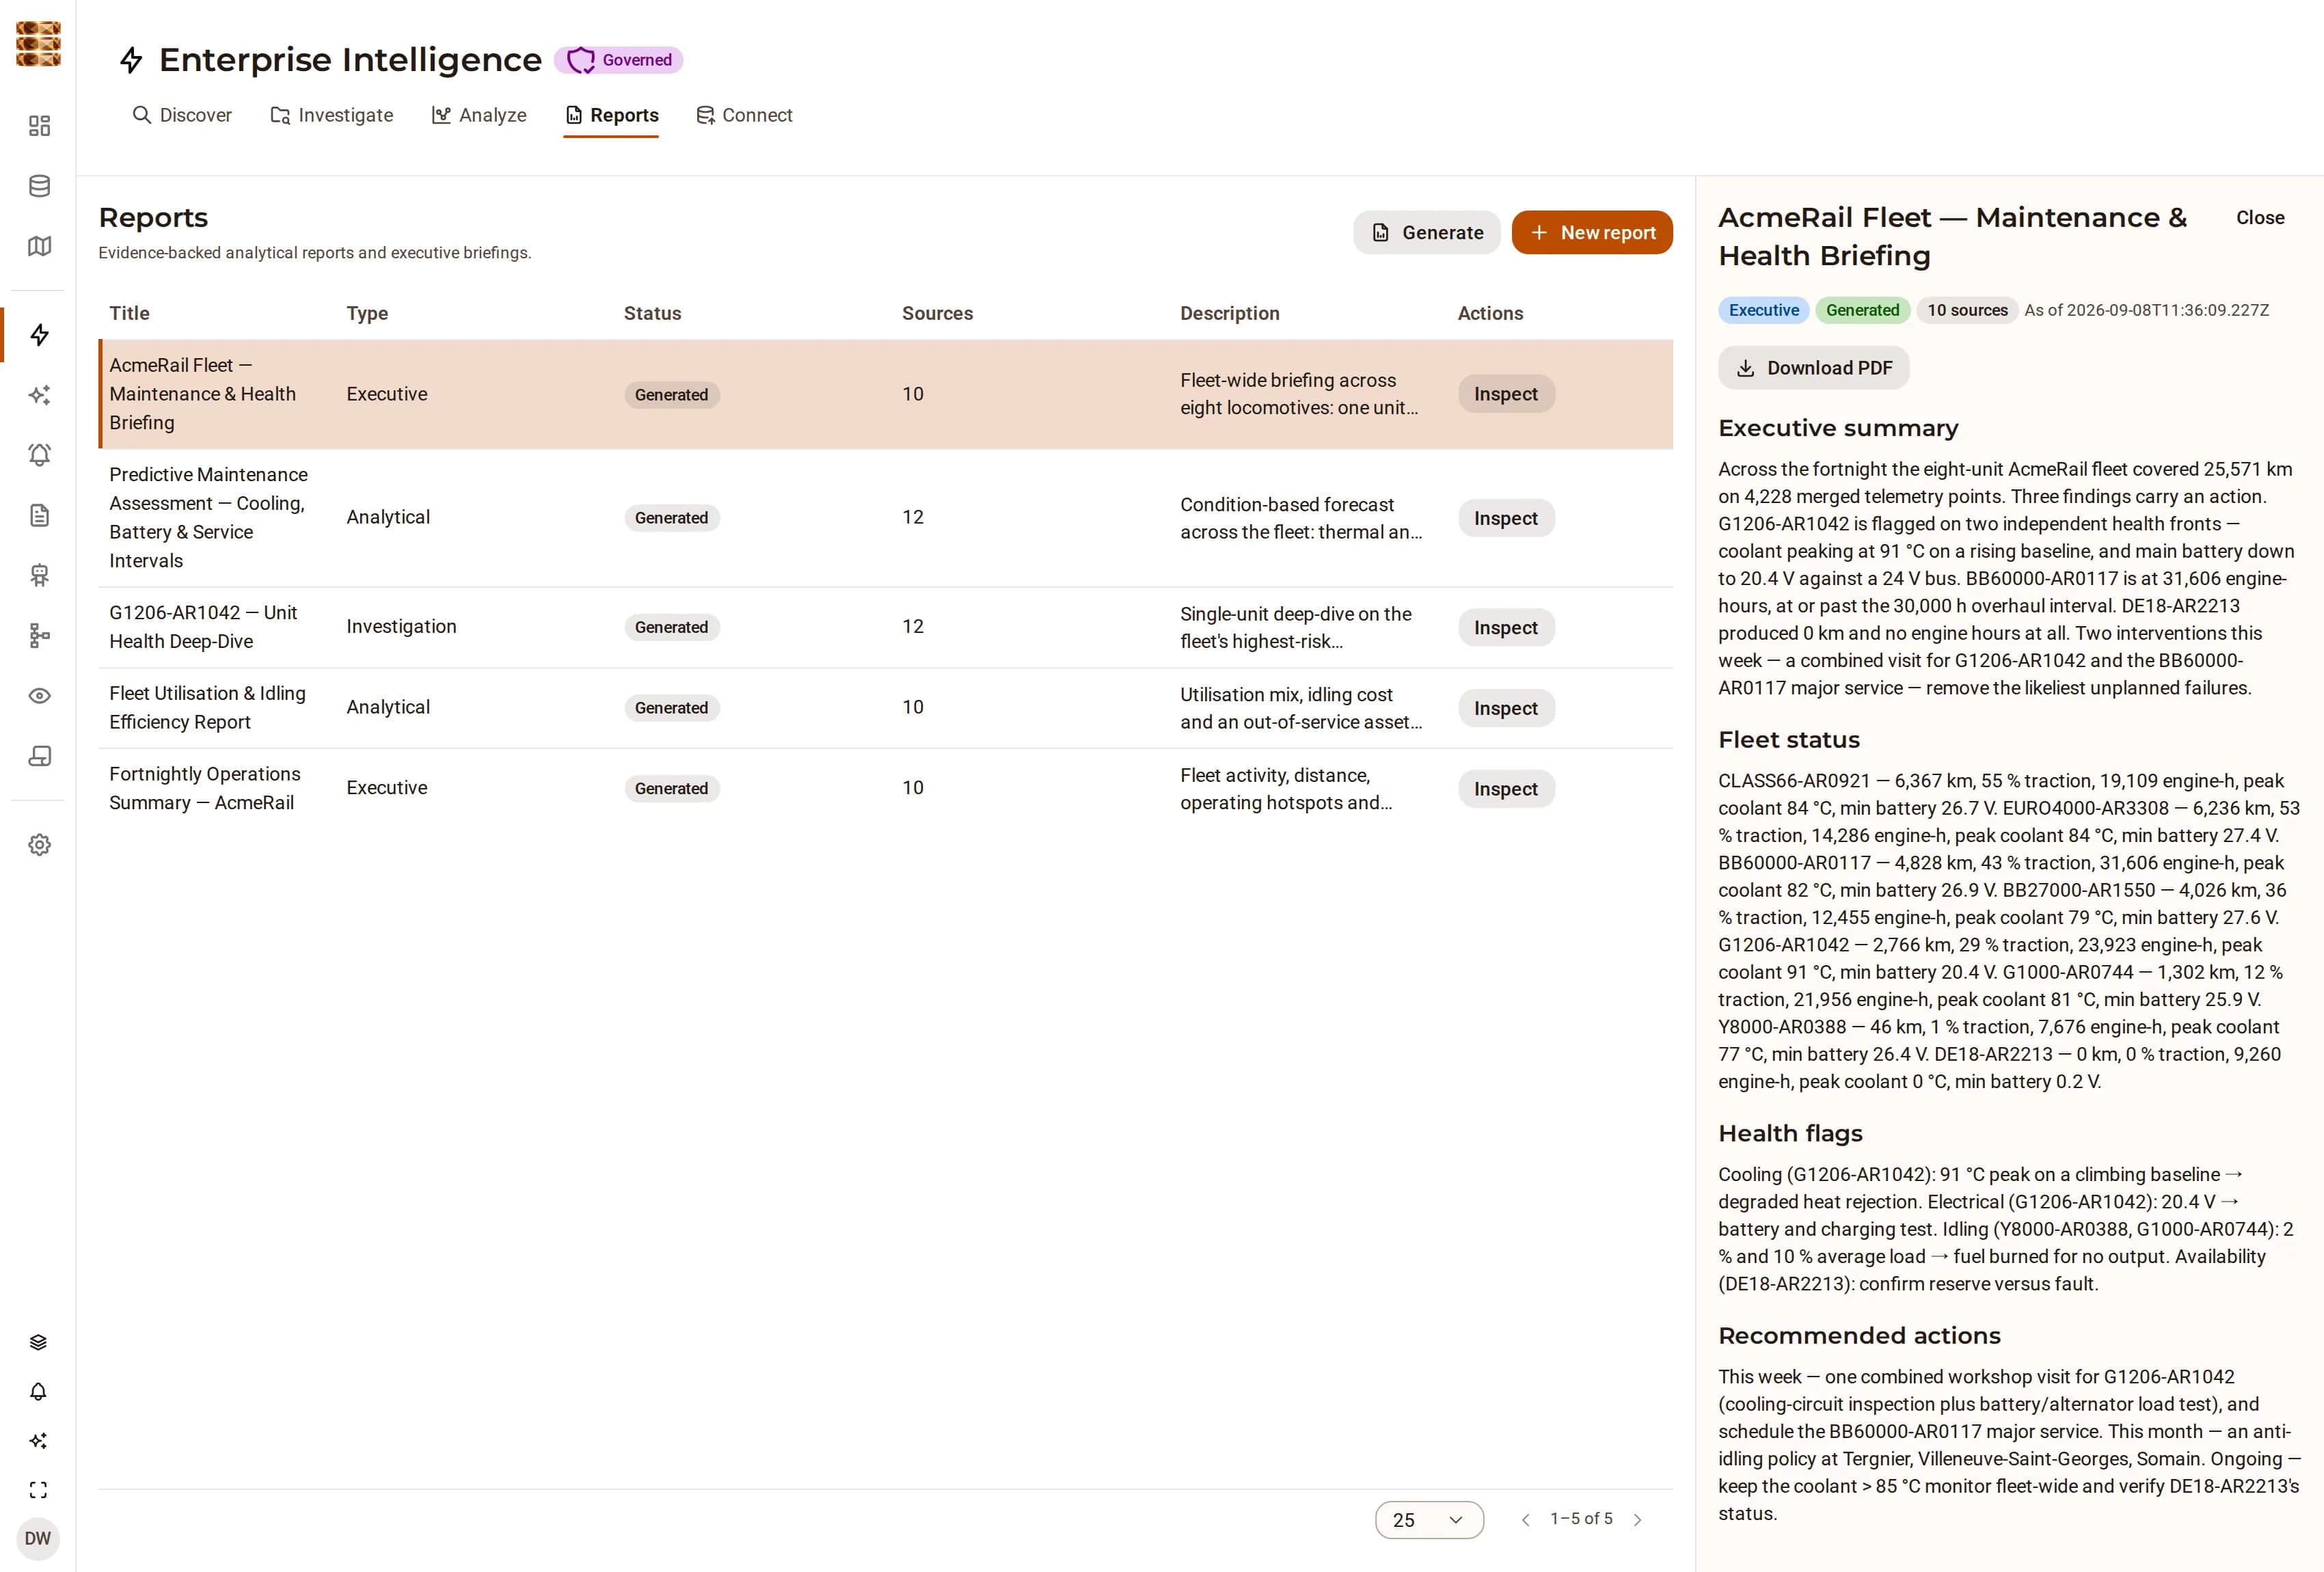
Un briefing généré de maintenance et de santé de la flotte AcmeRail, avec un résumé exécutif, un statut de flotte par unité, des signaux de santé et des actions recommandées, chaque section citant la télémétrie dont elle se nourrit.
Le briefing cite la distance, les heures moteur, le pic de liquide de refroidissement et la tension de bus minimale par unité — tout étant lu depuis la télémétrie ingérée plutôt qu’écrit dans la prose.

IA et agents

Un agent à l’intérieur du modèle de permissions, pas à côté

L’assistant n’est pas une enveloppe qui lit votre écran. Il appelle la même API REST que vous, en tant que le principal que vous êtes, dans l’organisation où vous êtes — si bien qu’il n’existe aucun second modèle de permissions à maintenir synchronisé avec le premier, et rien qu’il puisse atteindre que vous ne pourriez pas.

01

Chaque écriture est approuvée

Les outils de lecture s’exécutent librement ; les outils qui créent, mettent à jour, suppriment ou relient quoi que ce soit s’arrêtent et affichent une carte approuver/rejeter dans la conversation. Vous voyez l’appel exact et ses arguments avant qu’il ne se produise.

02

Sa portée est un rôle, pas une instruction

Les outils sont contrôlés côté serveur par le rôle de l’appelant. On ne dit pas à l’assistant d’un lecteur de bien se comporter ; on lui remet un catalogue plus restreint. Il n’y a aucune instruction à contourner, parce que les outils d’écriture n’étaient de toute façon jamais présents dans la conversation.

03

Il répond avec les composants propres de la plateforme

Quand l’assistant rend compte de la santé du système, d’une exécution de vision ou d’un ensemble d’entités, il affiche le même composant React que le reste de l’application utilise pour ces données. Vous regardez la vue de l’enregistrement propre à la plateforme, pas la paraphrase qu’en fait le modèle.

04

Il peut poser des questions, et les secrets restent côté serveur

L’agent peut interrompre une tâche en cours pour du texte libre, un choix ou un mot de passe. Une réponse sensible est mise de côté côté serveur et n’atteint le modèle que comme une référence — si bien qu’un identifiant peut être utilisé par un outil sans jamais entrer dans la transcription.

05

46 outils MCP, sur les mêmes gestionnaires que l’API REST

Les agents extérieurs à l’application atteignent la plateforme via un serveur Model Context Protocol qui fait passer le principal de la clé API dans les mêmes gestionnaires que ceux que les routes HTTP appellent. Les portées par jeton — lecture, écriture, administration, IA — sont bornées par le rôle propre du propriétaire, et seul le hachage SHA-256 d’un jeton est stocké.

06

L’assistant propose une ontologie ; seule une personne en adopte une

Pointé vers ce qui a été ingéré, l’agent infère les types d’entités, leurs champs et les relations entre eux, et écrit le résultat comme un enregistrement de proposition. Accepter une proposition crée les types via la même API qu’utiliserait une personne ; rien ne change de la propre autorité d’un modèle.

DjiniousData
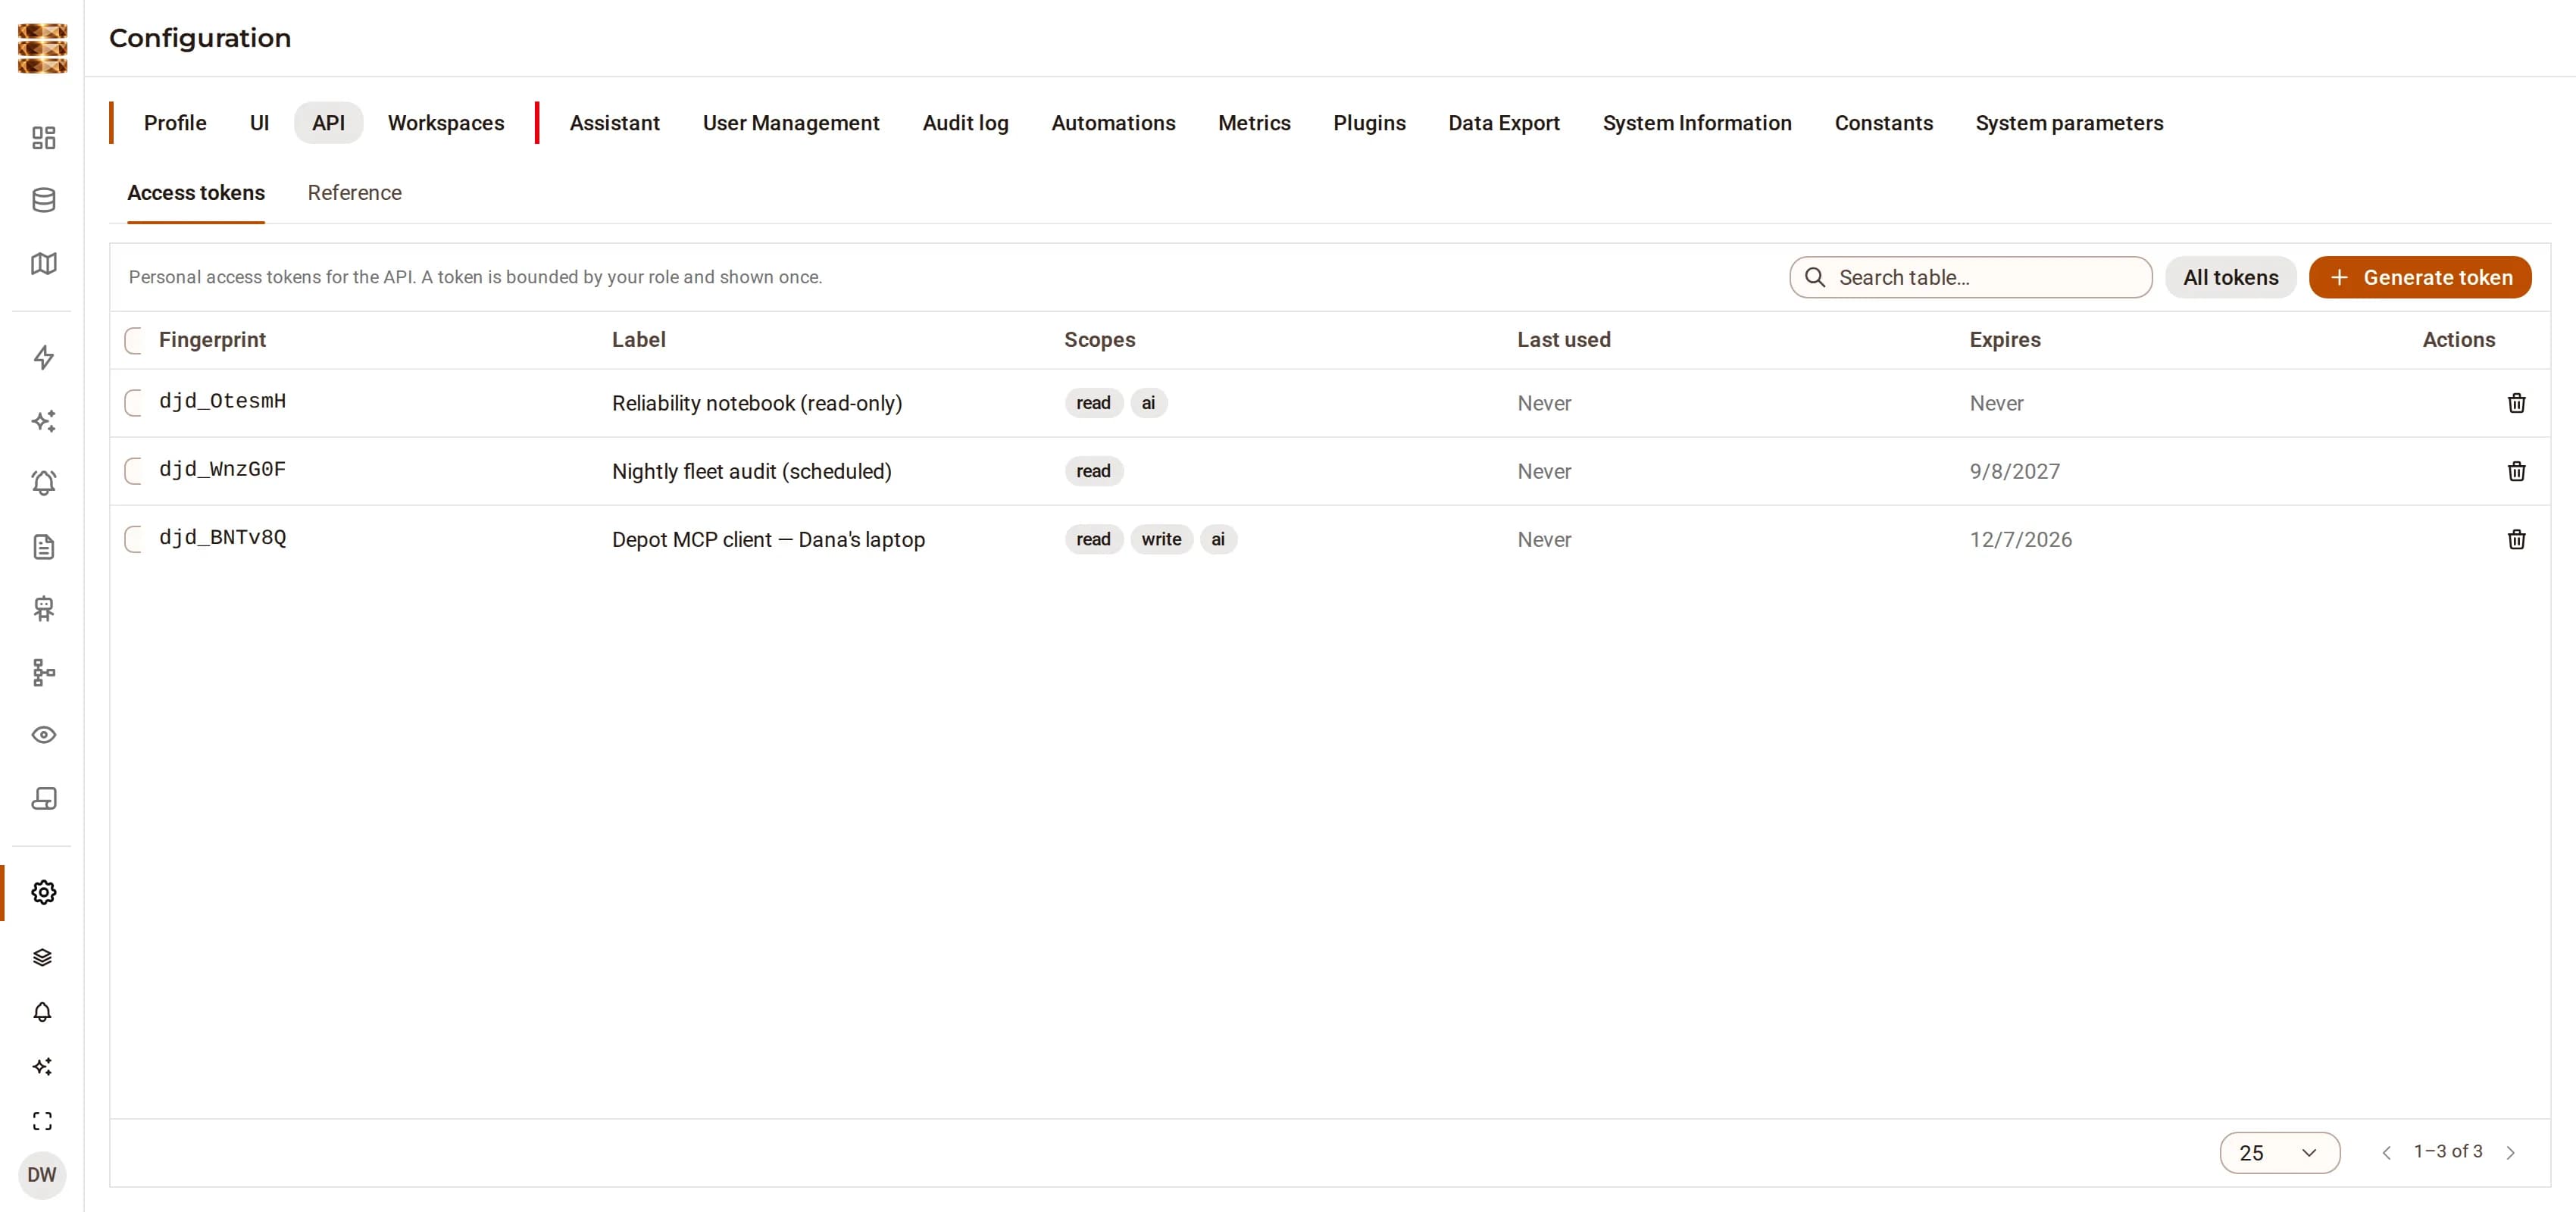
Le panneau des jetons d’accès API dans les paramètres de DjiniousData, listant trois jetons émis pour un client MCP, un audit planifié et un notebook en lecture seule, chacun avec son empreinte, ses portées, son état de dernière utilisation et son expiration.
Les jetons sont émis par agent et leur portée est définie indépendamment. Seul le hachage est stocké, le secret est affiché une seule fois, et en révoquer un laisse les autres fonctionner.

Capacités

Toute la surface, partie par partie

DjiniousData est un seul processus Bun — HTTP, WebSocket et tâches de fond — au-dessus de SurrealDB pour les enregistrements, le graphe, les vecteurs et le texte intégral, et de TimescaleDB pour les séries temporelles, avec un client React par-dessus.

Ingérer6 capacités

Le magasin de documents

Téléversez dans des dossiers persistants, sélectionnez ce que vous voulez, et ingérez. CSV, XLS/XLSX, PDF, DOCX, JSON, Markdown et texte brut sont analysés dans le processus — PDF et DOCX sans binaire externe — et chaque ligne tabulaire devient son propre objet de connaissance.

Connecteurs

Les systèmes externes arrivent via des instances de connecteurs, chacune estampillant son propre nom de source pour qu’un tableau de bord puisse filtrer sur exactement un flux. Les connecteurs portent un intervalle de synchronisation, et une tâche planifiée récurrente synchronise ceux dont l’intervalle est écoulé.

Le pipeline

Sept étapes, dans l’ordre : analyser, normaliser, dédupliquer, mapper les permissions, enrichir, vectoriser, persister. Chacune est une fonction pure de l’enveloppe qui lui est transmise, ce qui explique pourquoi la même chaîne s’exécute pour un téléversement de fichier, une synchronisation de connecteur et un préchargement de jeu de données.

Provenance, validée

Chaque objet enregistre son système source, l’identifiant de son objet source, son URI d’origine, son heure d’ingestion et sa version de pipeline. Un objet qui échoue à la validation de provenance déclenche une erreur terminale au lieu d’être stocké — et un objet dérivé sans références parentes échoue aussi.

Déduplication

Un index unique sur (source, identifiant externe) plus un hachage de contenu. Réingérer une ligne inchangée ne touche que son heure de mise à jour, rien d’autre ; une ligne modifiée est mise à jour en place. Deux écrivains en concurrence sur la même clé convergent vers un seul enregistrement plutôt que deux.

Des séries temporelles en parallèle

Les colonnes numériques sont aussi écrites dans une table de métriques TimescaleDB lors du même chargement, si bien qu’une règle de seuil et un graphique de tendance lisent la même ingestion plutôt qu’une seconde copie susceptible de diverger.

Modéliser5 capacités

Les types sont des enregistrements

Les types d’entités et les types de relations sont des lignes, créées via l’interface ou l’API. Champs, libellés, pluriels, icônes et flux de statuts sont tous des données. Il n’y a aucun code généré ni aucune migration entre la définition d’un type et son utilisation.

CRUD générique

Toutes les lectures et écritures d’entités passent par un seul jeu de points de terminaison sous /api/entities, piloté par la définition du type. Un nouveau type reçoit sa vue de liste, sa page de détail, ses facettes de recherche et ses outils agent sans qu’une seule ligne n’ait été écrite pour lui.

Surcouches par organisation

Une surcouche indexée par (type, organisation) superpose des champs, des libellés et des états de flux supplémentaires à un type de base partagé, résolue pour la propre organisation de l’appelant. L’extension d’un client ne devient pas le schéma de tous les clients.

Entité ↔ organisation

Chaque entité porte une relation dérivée vers l’organisation qui la possède. Elle est synthétisée à partir du champ de propriété plutôt que stockée comme une arête, si bien qu’elle ne peut pas se désynchroniser de l’enregistrement, et elle est en lecture seule dans l’explorateur de graphe.

Types proposés par l’IA

L’assistant peut lire ce qui a été ingéré et en proposer une ontologie — types, champs, relations. La proposition est un enregistrement que vous examinez et acceptez ou rejetez ; elle n’est jamais appliquée de la propre autorité du modèle.

Résoudre5 capacités

Correspondance déterministe

Un identifiant partagé obtient un score de 1,0, un nom normalisé exact 0,85, un nom flou 0,7. Les fonctions de correspondance sont des fonctions pures sans modèle derrière elles, si bien que les deux mêmes enregistrements obtiennent le même score aujourd’hui et le trimestre prochain.

Le regroupement, et la ligne

Blocking, notation par paires, puis union-find. Les paires à 0,85 ou au-dessus sont fusionnées automatiquement ; un flou à 0,7 reste candidat. Cet écart est délibéré — c’est là qu’une personne a sa place.

Les décisions des analystes sont durables

Quand un analyste confirme ou rejette un candidat, la décision est stockée, et l’exécution de résolution suivante la respecte. Réexécuter le pipeline ne remet pas en cause un jugement que quelqu’un a déjà rendu.

Les arêtes portent des preuves

Les arêtes matérialisées du graphe conservent des références aux objets dont elles sont dérivées, si bien qu’une arête répond à « pourquoi pensez-vous que ceux-ci sont liés » avec des lignes plutôt qu’avec un niveau de confiance.

Un parcours restreint

Les recherches de voisins filtrent selon les permissions de l’appelant avant de renvoyer, pas après. Un graphe qui filtrerait après vous aurait quand même révélé que le nœud existait.

Surveiller5 capacités

Des widgets sur les enregistrements

Les widgets de métrique, de ventilation, de tendance et de carte interrogent directement les objets de connaissance, avec une facette, un filtre, un champ de métrique et une agrégation. Il n’existe aucune table de tableau de bord matérialisée à rafraîchir, et donc aucune à devenir obsolète.

Le widget carte

La dernière position par groupe, tracée sur le même composant de carte que le reste de l’application utilise. Il est alimenté par l’ingestion ordinaire, si bien qu’une flotte apparaît sur un tableau de bord parce que sa télémétrie a été chargée, pas parce qu’une fonctionnalité de cartographie a été achetée.

Règles d’alerte de télémétrie

Une règle surveille un maximum, un minimum, une moyenne ou un dénombrement d’un champ autorisé sur une source, groupé — par locomotive, par site, par équipement — et se déclenche quand il franchit un seuil. Les règles sont restreintes à leur propriétaire et s’évaluent par rapport à ce que ce propriétaire peut voir.

Tableaux de bord partagés

Un tableau de bord est un enregistrement nommé, restreint à une organisation et un espace de travail. Le publier est la façon dont une équipe obtient la même vue, plutôt que chacun la reconstruisant à partir du même catalogue de widgets.

Mises à jour en direct

Les flux de changements de la base de données se diffusent via un concentrateur WebSocket, si bien qu’une page reflète une écriture d’une autre session sans boucle de scrutation en dessous.

Vision5 capacités

La détection comme ingestion

Un pipeline de détection d’objets s’exécute sur un document stocké, une URL publique ou un flux en direct, et ses résultats se matérialisent de trois façons : des métriques pour les graphiques et les alertes, un objet de connaissance pour la recherche, et éventuellement une entité par objet suivi.

Les détections ne sont pas des objets

Un traqueur regroupe des centaines de cadres d’un même camion garé en une seule piste, parce que le chiffre qui a sa place sur un tableau de bord est « un camion », pas « neuf cents détections ».

La réserve d’échantillonnage, énoncée

Le suivi suppose que les images échantillonnées consécutives se chevauchent. Sur des images 1080p60 d’un seul ouvrier qui marche, un pas d’échantillonnage de 30 a signalé 13 personnes distinctes et un pas de 5 en a signalé 2. Les comptages de détections ne sont pas affectés ; seul le comptage d’objets uniques se dégrade. Gardez l’intervalle échantillonné sous environ 0,2 s quand ce chiffre compte.

Les flux sont à activation volontaire

Les caméras sont de nature à réseau privé, si bien qu’une source de flux est refusée à moins que son préfixe ne figure sur la liste d’autorisation de l’exploitant. Les URL publiques sont vérifiées par rapport à la même protection que la plateforme utilise pour les webhooks.

Les résultats partiels survivent

Le worker renvoie les détections de manière incrémentale, ce qui rend une caméra en direct consultable et préserve le travail quand une longue exécution s’arrête à mi-chemin.

Agir5 capacités

Signaux

L’analyse produit des signaux — anomalies, motifs, signaux faibles — chacun avec un sujet, une méthode, un niveau de confiance et des références aux objets qui le sous-tendent. La sévérité est dérivée de la confiance plutôt que choisie.

Enquêtes

Un dossier rassemble signaux, notes et éléments de preuve en un seul fil avec un responsable et une priorité, si bien qu’un constat devient du travail plutôt qu’une carte qui défile et disparaît.

Rapports

Des rapports structurés avec des sections typées et des citations vers les objets source. Un rapport est généré à partir de l’état propre de la plateforme, si bien qu’un chiffre dans un rapport et la tuile dont il provient ne peuvent pas se contredire.

Automatisations

Des scripts avec planifications et webhooks, versionnés, avec des journaux d’exécution. Ils appellent l’API propre de la plateforme, ce qui signifie qu’une automatisation est soumise aux mêmes permissions que la personne qui l’a écrite.

Exporter

L’export PDF et Excel à partir des mêmes enregistrements que ceux que lit l’écran, plus une surface REST documentée pour tout le reste. L’API n’est pas un sous-ensemble de l’interface ; l’interface est une consommatrice de l’API.

En dessous4 capacités

SurrealDB possède

Les utilisateurs, identifiants, sessions, organisations, espaces de travail et adhésions ; l’ontologie et ses surcouches ; les objets de connaissance avec leurs vecteurs et leur index plein texte ; les entités résolues et les arêtes de graphe ; les tableaux de bord, règles d’alerte, signaux, enquêtes et rapports ; le journal d’audit et la file de tâches.

TimescaleDB possède

L’hypertable de métriques — les séries numériques extraites des lignes ingérées et envoyées par le worker de vision, où une requête regroupée par intervalles de temps sur des millions de points est tout le travail.

Pourquoi séparer, tout court

Un seul magasin pour les enregistrements signifie que le graphe, la recherche vectorielle et la recherche plein texte voient tous les mêmes lignes avec les mêmes permissions, sans synchronisation entre eux. Les séries temporelles sont la seule charge de travail qui veuille vraiment un moteur différent, alors elle en obtient un — et rien d’autre n’en obtient un.

Le coût, nommé

Deux connexions, deux modes de défaillance, et des métriques qui peuvent être en retard sur les enregistrements dont elles sont dérivées. L’ingestion écrit les deux depuis le même passage, si bien que la fenêtre est petite, mais elle n’est ni nulle ni cachée.

Confiance

Une portée appliquée là où les lignes sont sélectionnées, pas là où elles sont affichées

Le multi-tenant est habituellement un problème de revue : chaque nouvelle requête n’est qu’à un filtre oublié d’une fuite, et la défense est que quelqu’un l’aurait remarqué. DjiniousData resserre la frontière en un seul endroit par famille d’enregistrements, l’impose dans les gestionnaires que chaque route partage, et enregistre ce qui s’est passé, que quelqu’un surveille ou non.

Une seule liste de ce qui est restreint

Les familles d’enregistrements qui appartiennent à un client — objets de connaissance, entités résolues, documents, tableaux de bord, règles d’alerte, signaux, dossiers, rapports — sont énumérées dans un seul module. Ajouter une table qui devrait être restreinte est un changement d’une ligne à cet endroit, plutôt qu’un audit de chaque gestionnaire susceptible de la toucher.

WORKSPACED_TABLES

Le paramètre de restriction ne peut que restreindre

Un appelant peut demander à voir moins. Nommer une organisation autre que la sienne n’élargit pas le résultat : un utilisateur client est lié côté serveur à sa propre organisation, quoi qu’il transmette.

?organization=

Deux niveaux d’administration, pas de second rôle

Un administrateur sans organisation est un super-utilisateur inter-clients ; un administrateur avec une organisation y est restreint. Un administrateur d’organisation ne peut pas créer d’administrateur global, déplacer un utilisateur entre organisations, ni modifier l’ontologie de base partagée.

isGlobalAdmin · isOrgAdmin

Les agents sont des principaux, pas des exceptions

Le serveur MCP fait passer le principal de la clé API dans les mêmes gestionnaires qu’utilisent les routes REST. Il n’existe aucun chemin en forme d’agent qui contourne les vérifications, et la portée d’un jeton est bornée par le rôle de l’utilisateur qui l’a émis.

Répartition MCP

Un journal d’audit en ajout seul, écrit au passage

Chaque mutation est enregistrée au moment où elle se produit — qui, quelle action, quel enregistrement, et depuis où — par le middleware que traverse chaque route. Les changements d’entités, d’ontologie, de connecteurs, de jetons et de règles d’alerte atterrissent tous dans le même journal, et une tâche de rétention balaie les événements expirés et les sessions mortes selon une planification.

audit

Un compte, un hachage

Des identifiants Argon2id, vérifiés par rapport à une base d’identité partagée pour qu’un seul compte fonctionne sur toutes les applications Djinious, et des sessions sous forme de JWT signé avec HMAC-SHA256. Les rôles sont administrateur, utilisateur et lecteur ; les vérifications côté serveur vivent à côté des gestionnaires, et l’interface les reflète mais n’est jamais l’application des règles.

Argon2id · JWT

Où sont les limites

Les enregistrements et les séries temporelles vivent dans deux magasins, si bien qu’une requête de métriques peut être momentanément en retard sur les enregistrements dont elle est dérivée. L’ingestion pilotée par connecteur s’exécute hors d’un contexte de requête et n’estampille pas d’organisation sur les objets qu’elle écrit ; un déploiement qui ingère par client leur définit une portée explicite.

limites énoncées

Dans le fil numérique

Ce qu’elle reçoit. Ce qu’elle transmet.

DjiniousData assure sa part de la boucle d’ingénierie et transmet ses preuves — et fonctionne tout aussi bien seule.

Seule

DjiniousData est à elle seule une plateforme de données complète et API-first : apportez les fichiers, connecteurs et flux que vous avez déjà, et elle les ingère, les modélise, les résout et les surveille sans aucune autre partie de la suite.

Réserver une démo

Voyez-la sur votre problème.

Apportez l’export auquel personne ne fait confiance. Quatre-vingt-dix minutes sur vos propres données, pas les nôtres. Nous l’ingérerons devant vous et lirons le résultat au fur et à mesure — y compris les lignes que la plateforme refuse de fusionner, et pourquoi elle les retient.

  1. Ingérez un fichier que vous apportez — un CSV, une feuille de calcul, un PDF — et regardez ce qu’il devient
  2. Lisez sa provenance à voix haute : système source, objet source, heure d’ingestion, et le hachage de contenu qui rend une réingestion sans effet
  3. Modélisez-le en types d’entités et de relations, en direct, et regardez les vues de liste et les pages de détail apparaître sans déploiement
  4. Résolvez les doublons qu’il contient, et regardez les paires que la plateforme n’a délibérément pas fusionnées
  5. Placez-y une tuile de tableau de bord et une règle de seuil, puis cliquez sur la tuile jusqu’aux lignes sous-jacentes
  6. Posez à l’assistant une question que nous n’avons pas préparée, et regardez vers quels outils il se tourne