 Djinious





Inferenza bayesiana e UQ
Non una singola risposta — una distribuzione di risposte, con una fiducia calibrata. Il Markov-Chain Monte Carlo adatta un modello a dati rumorosi e quantifica quanto dovresti esserne sicuro: posteriori che corrispondono alla forma chiusa dove ne esiste una, bande di credibilità sulle previsioni, confronto tra modelli e una verifica di copertura.
 DjiniousLab
- MCMC vs posteriore analitico (differenza sulla media)
- 0.002MCMC vs posteriore analitico (differenza sulla media)
- R̂ di Gelman–Rubin (convergente)
- 1.001R̂ di Gelman–Rubin (convergente)
- copertura degli intervalli al 90%
- 86%copertura degli intervalli al 90%
- intervalli di credibilità che contengono il valore vero
- ✓intervalli di credibilità che contengono il valore vero
- notebook di progettazione
- 10notebook di progettazione
- requisiti PASS
- 5 / 5requisiti PASS
La risposta onesta è una distribuzione, non un numero.
Ogni altro modello di questo portfolio dà una sola risposta. Ma adatta un modello a dati rumorosi e la risposta corretta non è «il tasso è 0,7» — è «0,7, ed ecco esattamente quanto ne sono sicuro». L’inferenza bayesiana produce proprio questo: una distribuzione a posteriori completa sui parametri, e un’incertezza calibrata su ogni previsione. Il Markov-Chain Monte Carlo è il motore. Questo programma lo costruisce a partire dal caso coniugato che puoi verificare a mano, fino a calibrare un modello dinamico e confrontarne diversi tra loro — e completa ogni altro flagship, perché l’incertezza può avvolgerli tutti.
Comincia da dove puoi verificare la risposta esattamente.
Per alcuni modelli il posteriore è analitico — un prior Beta e dati binomiali danno un posteriore Beta, in forma chiusa. Il programma parte da lì, osservando il posteriore che si affina sul valore vero man mano che arrivano i dati, perché è il caso in cui un campionatore può essere validato fino all’ultima cifra. Metti a punto il meccanismo dove puoi verificarlo, poi fidatene dove non puoi.
DjiniousLab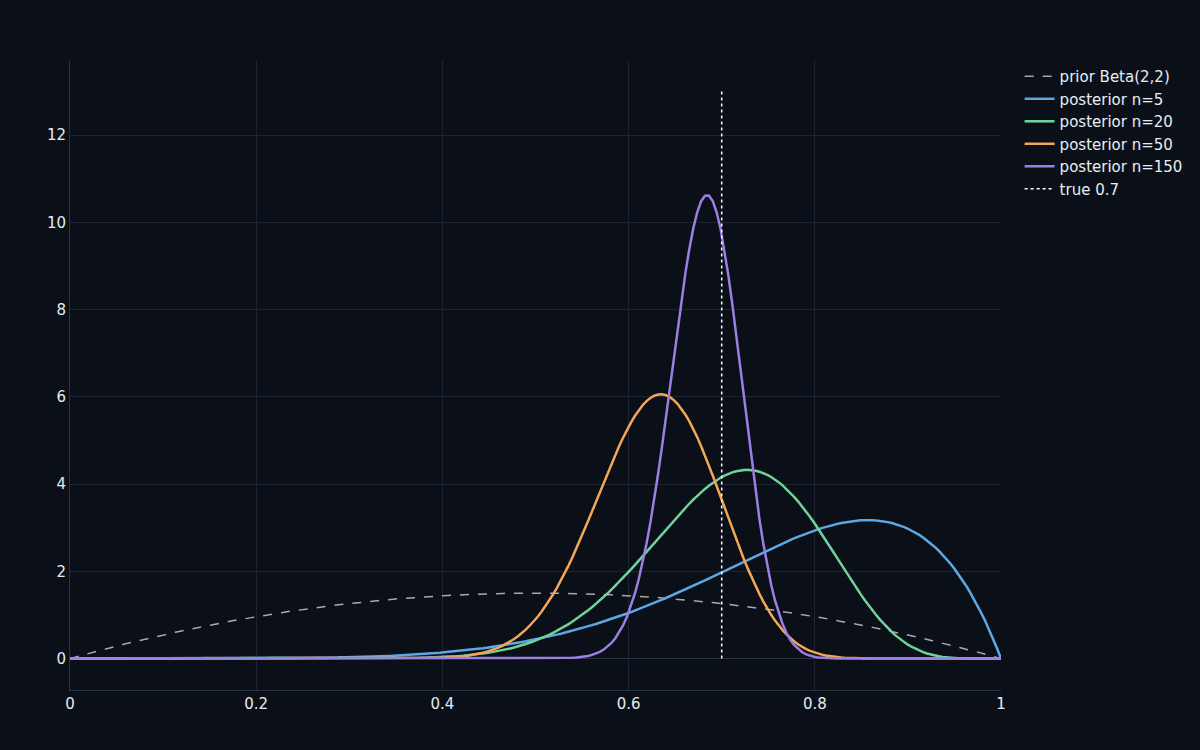 DjiniousLab
Un adattamento di cui non puoi dubitare è un adattamento di cui non puoi fidarti.
I minimi quadrati tracciano una sola retta tra i dati e si fermano. La regressione bayesiana traccia l’intero posteriore di rette — e la dispersione di quel ventaglio, stretta dove i dati sono densi e ampia dove sono radi, *è* l’incertezza. Questa è la differenza tra una previsione e una previsione su cui puoi agire: non solo la stima migliore, ma quanto potrebbe essere sbagliata, ovunque.
DjiniousLab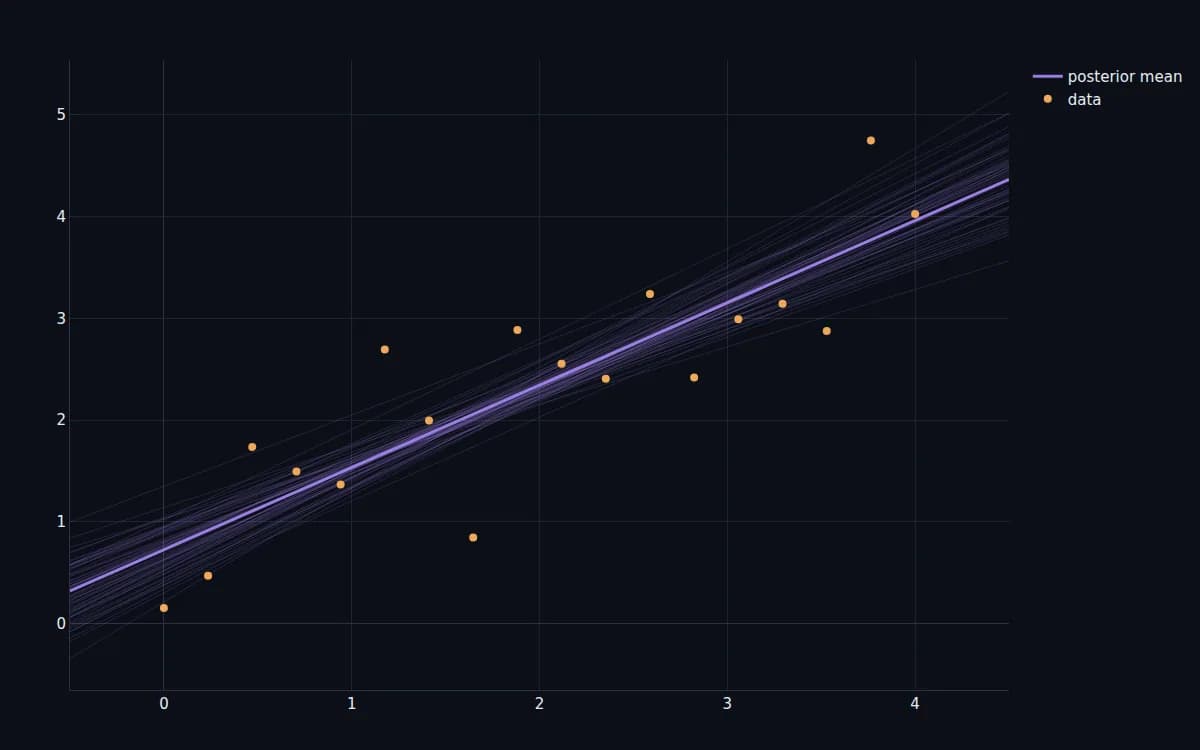
Calibra un modello dinamico — con barre d’errore.
Lo stesso meccanismo inferisce i parametri di una ODE. Date osservazioni rumorose di un segnale in decadimento, MCMC recupera il tasso di decadimento come posteriore (centrato sul valore vero), e propagando quel posteriore in avanti attraverso il modello si ottiene una banda predittiva a posteriori — una previsione che porta con sé la propria incertezza. E il programma verifica che l’incertezza sia onesta: su molte repliche, gli intervalli di credibilità al 90% contengono il valore vero circa il 90% delle volte. Calibrazione, verificata.
DjiniousLab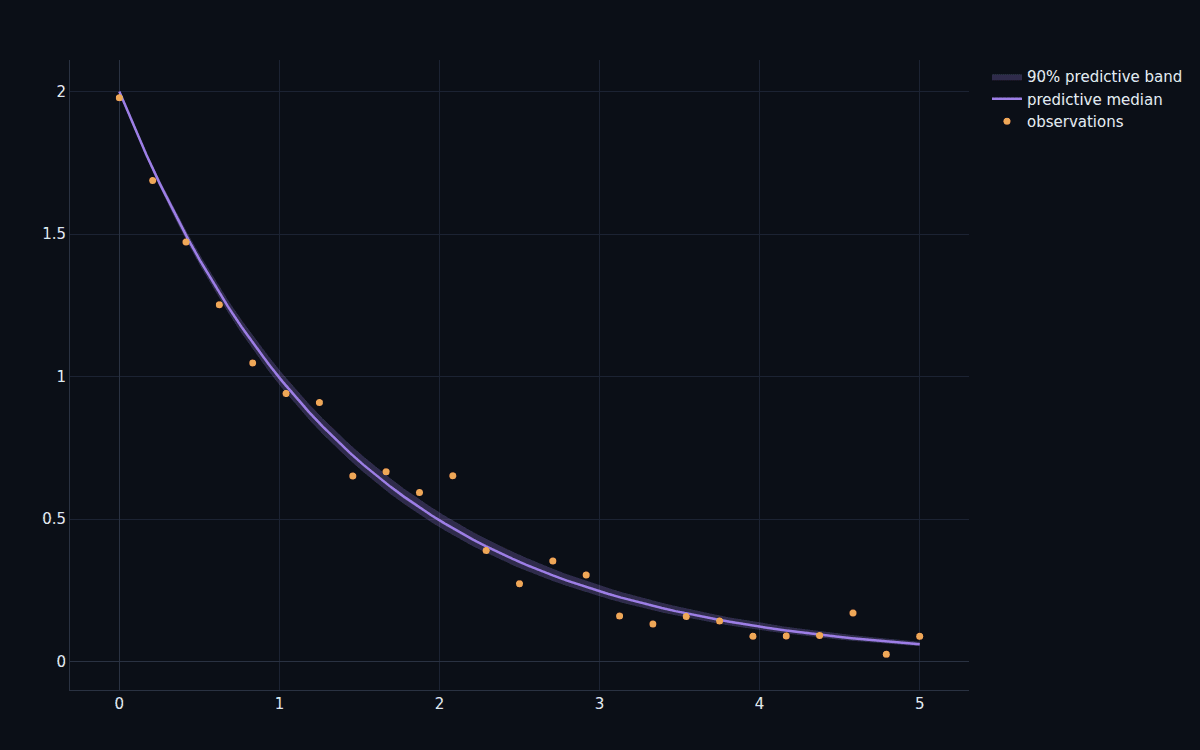
Lascia che siano i dati a scegliere il modello — e penalizza la complessità.
Dati modelli concorrenti — una retta contro una parabola — quale sostengono i dati? Un modello più complesso si adatta sempre meglio ai dati di addestramento, quindi il confronto onesto penalizza la complessità. Il criterio di informazione bayesiano fa esattamente questo, e su una scansione di gradi polinomiali raggiunge il minimo esattamente al grado vero: abbastanza flessibilità per adattarsi al segnale, non di più. Il rasoio di Occam, reso quantitativo.
DjiniousLab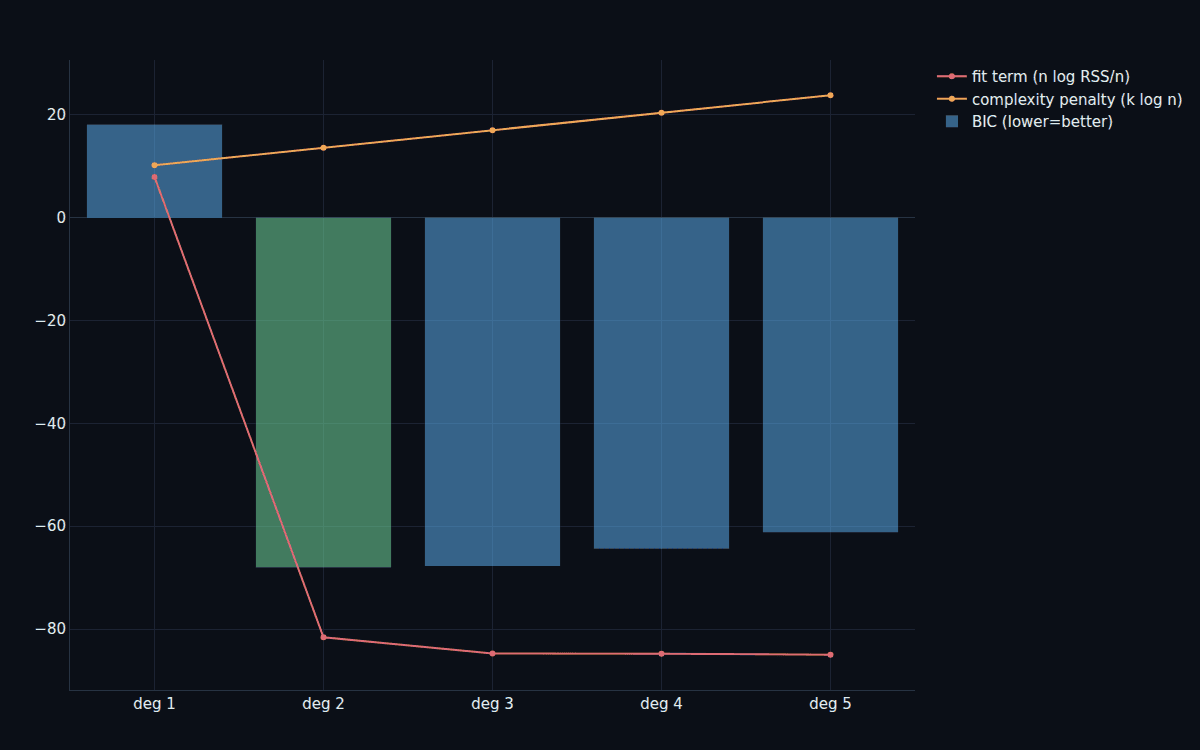
Ogni numero ridedotto in fase di collaudo finale.
Il notebook V&V ricostruisce ogni campionatore da zero con seed fissi e ridefinisce i requisiti rispetto alla teoria, stampando un quadro PASS/FAIL.
Risultato
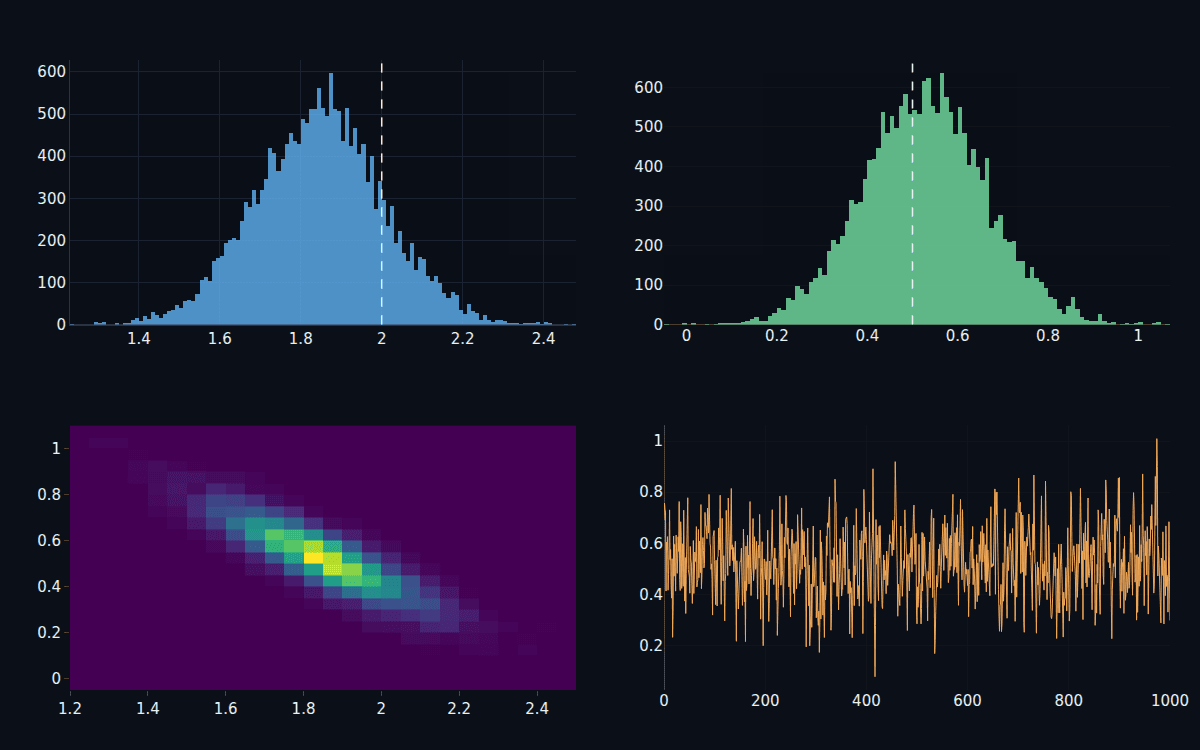
- MCMC vs posteriore analitico: differenza sulla media 0,002
- Recupero dei parametri (IC ∋ valore vero): 1,85 / 0,53
- R̂ multi-catena: 1,001
- Copertura dell’intervallo predittivo: 86%
- Confronto tra modelli (BIC): grado vero
Requisito
- MCMC vs posteriore analitico: R-01
- Recupero dei parametri (IC ∋ valore vero): R-02
- R̂ multi-catena: R-03 ≈ 1
- Copertura dell’intervallo predittivo: R-04 ≈ 90%
- Confronto tra modelli (BIC): R-05
Il paradigma del campionamento, ancorato alla teoria.
Il deliverable è composto da dieci notebook e dal dossier — campionatori MCMC e posteriori, non una rete acausale, quindi non c’è alcun blocco personalizzato né canvas. Il campionatore è Metropolis–Hastings a passeggiata casuale (non HMC/NUTS basato su gradiente), le verosimiglianze sono gaussiane, le catene hanno lunghezza modesta, i modelli sono a bassa dimensionalità, il confronto tra modelli usa un criterio di informazione anziché una verosimiglianza marginale completa, e nulla è calibrato su un dataset del mondo reale. Ciò che il programma dimostra è il paradigma bayesiano stesso — una distribuzione di risposte con incertezza calibrata — validato rispetto a posteriori in forma chiusa dove esistono, e che arriva alla calibrazione di modelli dinamici, alla propagazione dell’incertezza e al confronto tra modelli dove non esistono. È lo strato di incertezza che può avvolgere qualsiasi altro flagship.
Continua a esplorare
Casi d’uso correlati
 Controllo embedded safety-criticalNove funzioni di sicurezza, dal requisito YAML al Rust embedded certificatoIl progetto di riferimento del voter porta nove funzioni di sicurezza — voto, latching, limitazione di slew rate, monitoraggio del trip, interblocchi e un misuratore di flusso con un confine in virgola mobile — attraverso tutti e tredici i gate, e riproduce ognuna su un Cortex-M4F emulato.
 DjiniousSafe
 Controllo e apprendimento per rinforzoControllo del cart-pole e RLIl benchmark canonico del controllo sottoattuato, affrontato end-to-end — dinamica non lineare, un LQR che stabilizza il pendolo invertito, un avviamento a oscillazione energetica, una policy di apprendimento per rinforzo model-free, e un gate di robustezza Monte Carlo.DjiniousLab
 ElettromagnetismoElettromagnetismo (FDTD)Risolvere le equazioni di Maxwell su una griglia — i campi elettrico e magnetico che si susseguono a salti nello spazio e nel tempo. Un risolutore FDTD autonomo riproduce i fenomeni ondulatori canonici: irradiazione, rifrazione, diffrazione, diffusione e risonanza di cavità. Il fratello a campo del CFD, in elettromagnetismo.DjiniousLab