 Djinious





Inférence bayésienne et UQ
Pas une seule réponse — une distribution de réponses, avec une confiance calibrée. Le Monte-Carlo par chaînes de Markov ajuste un modèle à des données bruitées et quantifie le degré de certitude à avoir : des postérieures qui correspondent à la forme close là où elle existe, des bandes crédibles sur les prédictions, une comparaison de modèles, et une vérification de couverture.
 DjiniousLab
- MCMC vs postérieure analytique (écart de moyenne)
- 0.002MCMC vs postérieure analytique (écart de moyenne)
- Gelman–Rubin R̂ (convergé)
- 1.001Gelman–Rubin R̂ (convergé)
- couverture des intervalles à 90 %
- 86%couverture des intervalles à 90 %
- intervalles crédibles contenant la vérité
- ✓intervalles crédibles contenant la vérité
- notebooks de conception
- 10notebooks de conception
- exigences RÉUSSI
- 5 / 5exigences RÉUSSI
La réponse honnête est une distribution, pas un nombre.
Tous les autres modèles de ce portefeuille donnent une seule réponse. Mais ajustez un modèle à des données bruitées, et la bonne réponse n’est pas « le taux est de 0,7 » — c’est « 0,7, et voici exactement mon degré de certitude ». L’inférence bayésienne produit cela : une distribution postérieure complète sur les paramètres, et une incertitude calibrée sur chaque prédiction. Le Monte-Carlo par chaînes de Markov en est le moteur. Ce programme le construit depuis le cas conjugué vérifiable à la main jusqu’à la calibration d’un modèle dynamique et la comparaison de modèles concurrents — et il complète tous les autres programmes phares, car l’incertitude peut envelopper n’importe lequel d’entre eux.
Commencer là où l’on peut vérifier la réponse exactement.
Pour certains modèles, la postérieure est analytique — une loi a priori Beta et des données binomiales donnent une postérieure Beta, sous forme close. Le programme commence là, en observant la postérieure se resserrer sur la valeur vraie à mesure que les données arrivent, car c’est le cas où un échantillonneur peut être validé jusqu’au dernier chiffre. Faire fonctionner correctement la mécanique là où on peut la vérifier, puis lui faire confiance là où on ne le peut pas.
DjiniousLab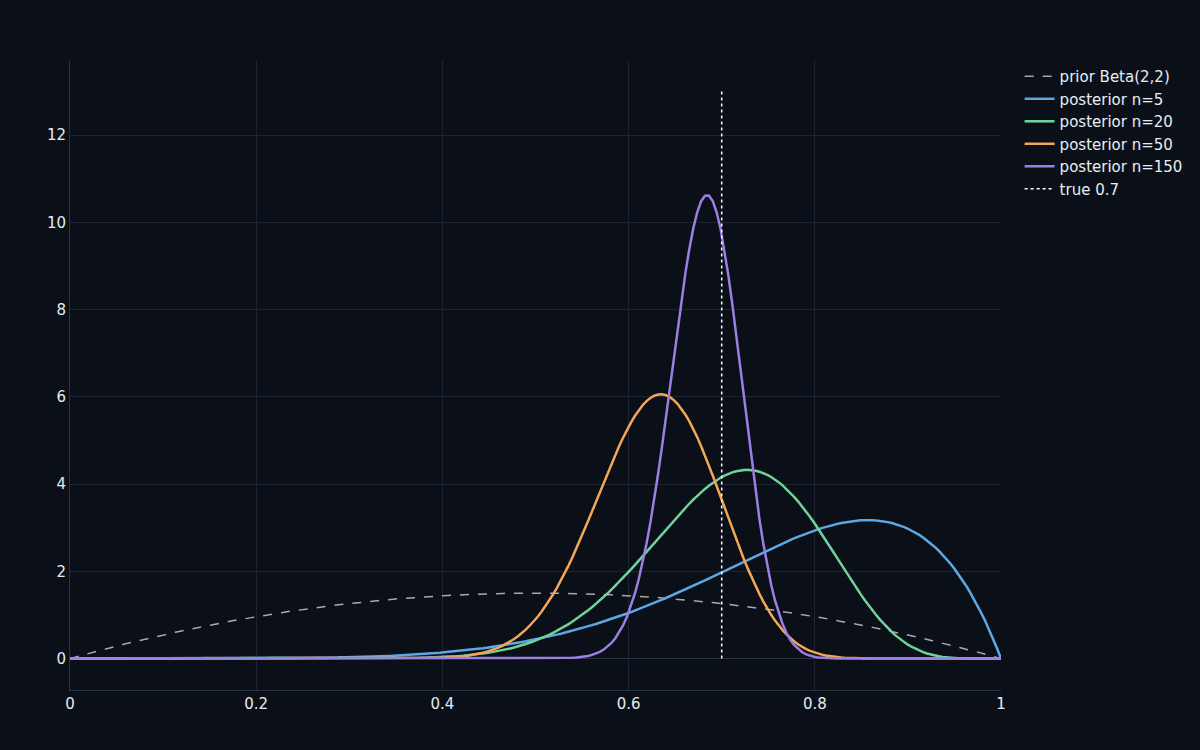 DjiniousLab
Un ajustement dont on ne peut pas douter est un ajustement auquel on ne peut pas faire confiance.
Les moindres carrés tracent une seule droite à travers les données et s’arrêtent là. La régression bayésienne trace toute la postérieure de droites possibles — et l’étalement de cet éventail, étroit là où les données sont denses et évasé là où elles sont rares, *est* l’incertitude. C’est la différence entre une prédiction et une prédiction sur laquelle on peut agir : pas seulement la meilleure estimation, mais son écart possible, partout.
DjiniousLab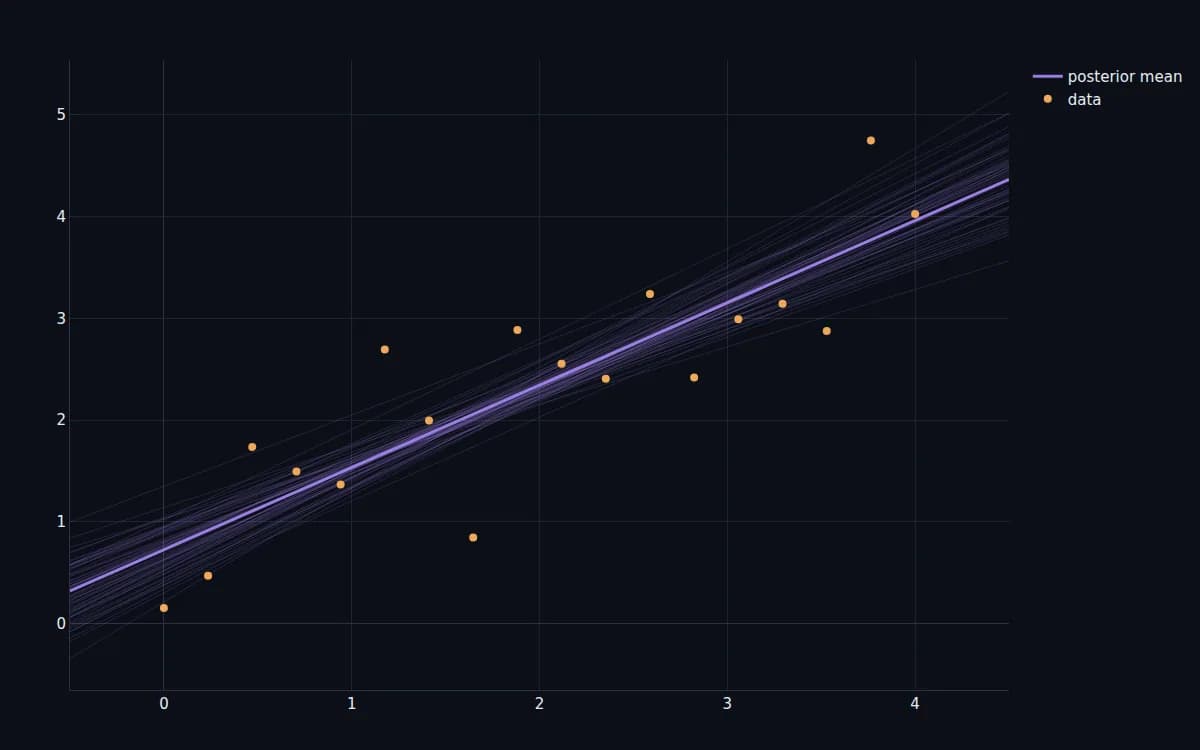
Calibrer un modèle dynamique — avec barres d’erreur.
La même mécanique infère les paramètres d’une EDO. À partir d’observations bruitées d’un signal en décroissance, le MCMC récupère le taux de décroissance sous forme de postérieure (centrée sur la vérité), et propager cette postérieure à travers le modèle produit une bande prédictive postérieure — une prévision qui porte sa propre incertitude. Et le programme vérifie que cette incertitude est honnête : sur de nombreuses répétitions, les intervalles crédibles à 90 % contiennent la vérité environ 90 % du temps. La calibration, vérifiée.
DjiniousLab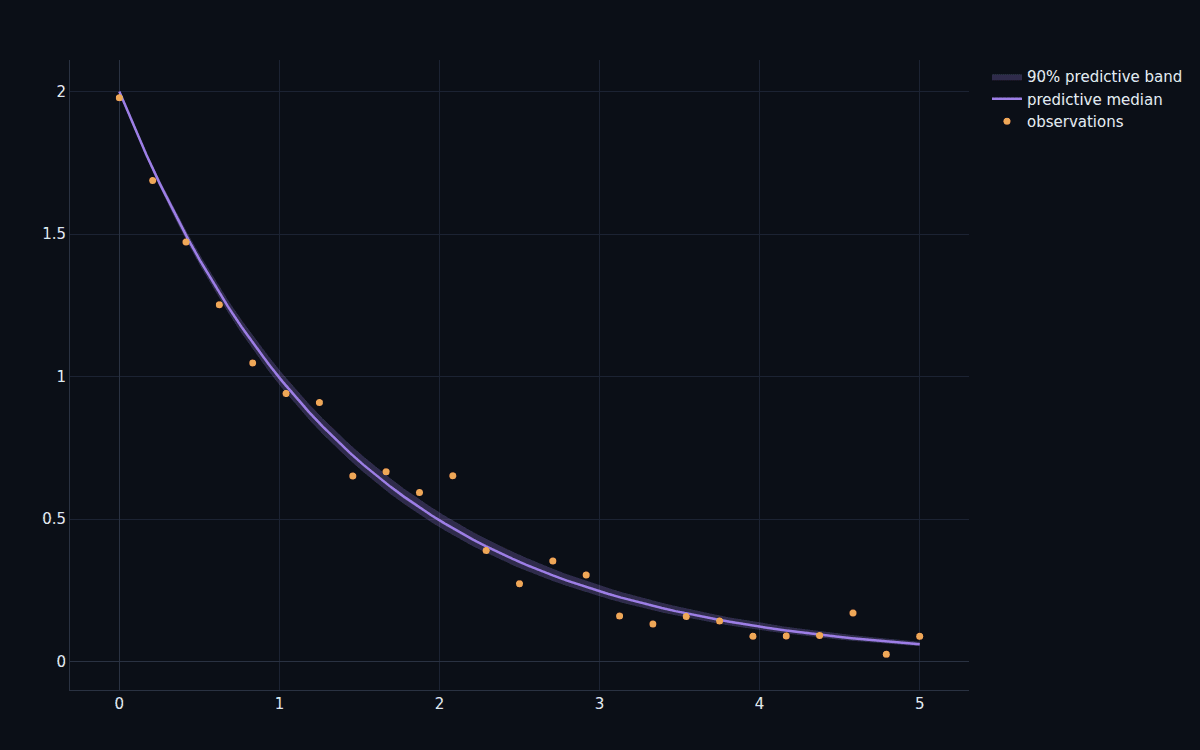
Laisser les données choisir le modèle — et pénaliser la complexité.
Face à des modèles concurrents — une droite contre une parabole — lequel les données soutiennent-elles ? Un modèle plus complexe s’ajuste toujours mieux aux données d’entraînement, donc une comparaison honnête pénalise la complexité. Le critère d’information bayésien fait exactement cela, et sur un balayage de degrés polynomiaux, il atteint son minimum au degré vrai : assez de flexibilité pour capter le signal, pas plus. Le rasoir d’Occam, rendu quantitatif.
DjiniousLab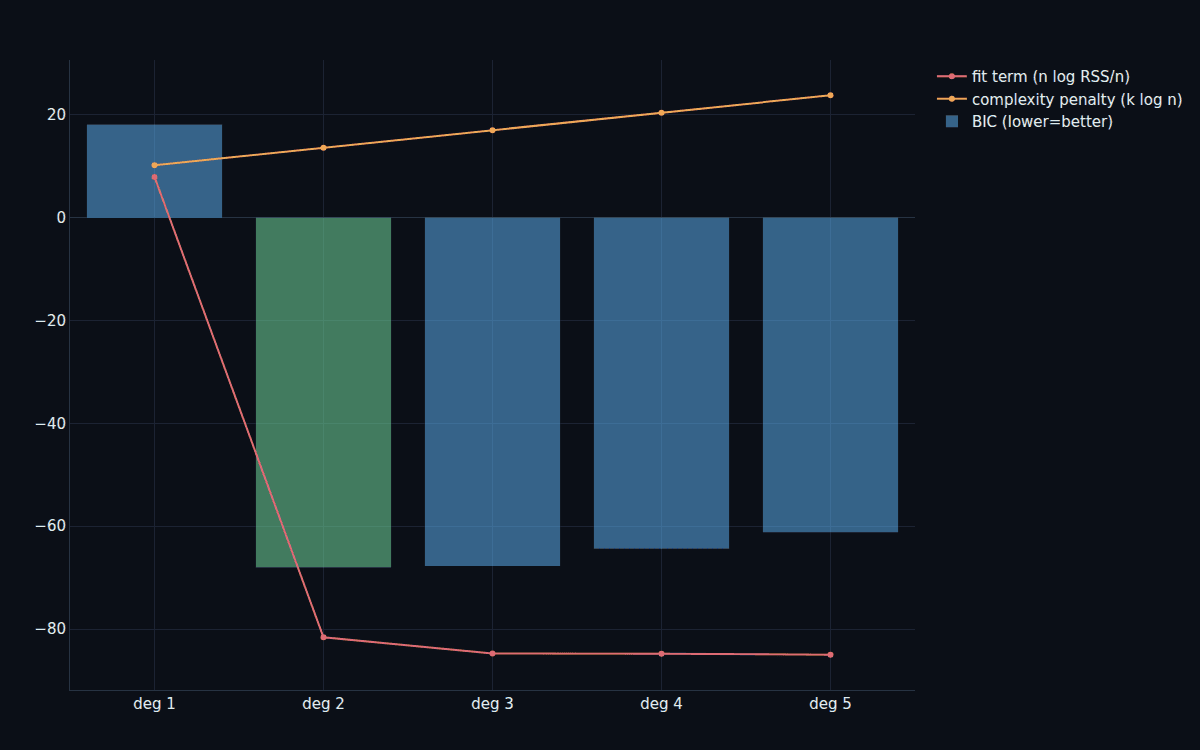
Chaque valeur re-dérivée au moment de la validation finale.
Le notebook V&V reconstruit chaque échantillonneur depuis zéro avec des graines fixes et re-dérive les exigences par rapport à la théorie, en affichant un tableau RÉUSSI/ÉCHEC.
Résultat
- MCMC vs postérieure analytique : écart de moyenne 0,002
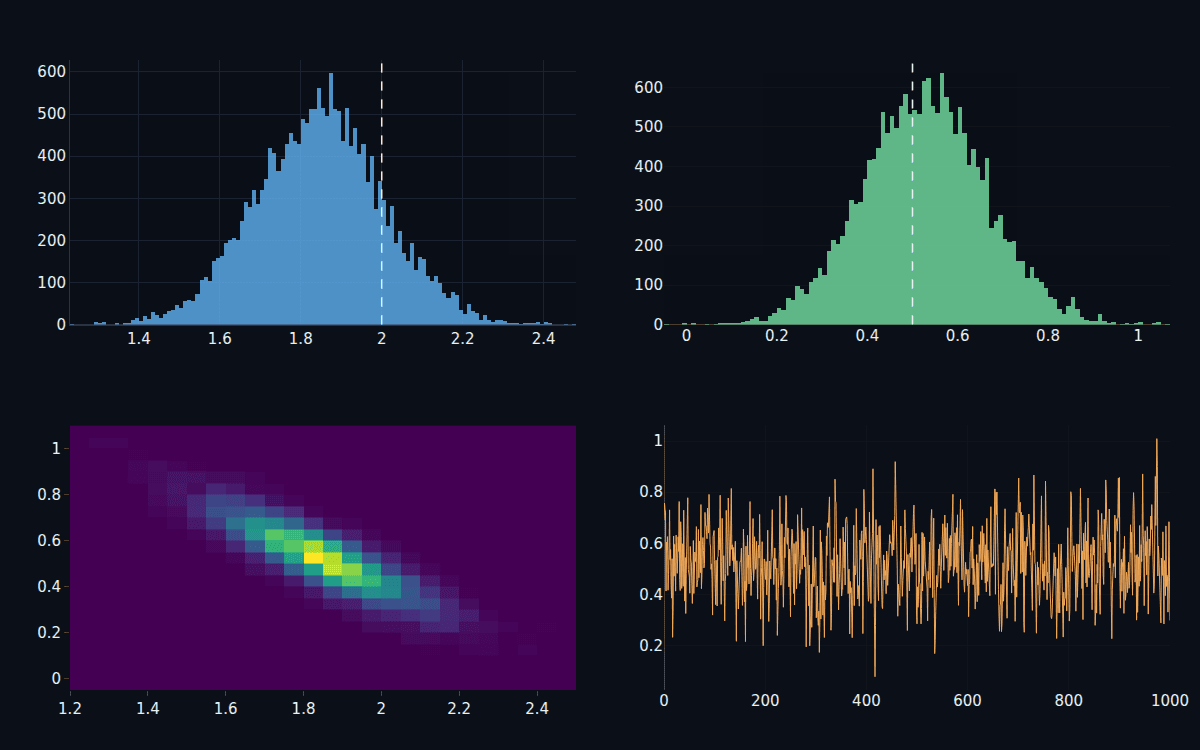
- Récupération des paramètres (IC ∋ vérité) : 1,85 / 0,53
- R̂ multi-chaînes : 1,001
- Couverture de l’intervalle prédictif : 86 %
- Comparaison de modèles (BIC) : degré vrai
Exigence
- MCMC vs postérieure analytique : R-01
- Récupération des paramètres (IC ∋ vérité) : R-02
- R̂ multi-chaînes : R-03 ≈ 1
- Couverture de l’intervalle prédictif : R-04 ≈ 90 %
- Comparaison de modèles (BIC) : R-05
Le paradigme d’échantillonnage, ancré à la théorie.
Le livrable est dix notebooks et le dossier — des échantillonneurs MCMC et des postérieures, pas un réseau acausal, donc pas de bloc personnalisé ni de canevas. L’échantillonneur est un Metropolis-Hastings à marche aléatoire (et non un HMC/NUTS à base de gradient), les vraisemblances sont gaussiennes, les chaînes sont de longueur modeste, les modèles sont de faible dimension, la comparaison de modèles utilise un critère d’information plutôt qu’une vraisemblance marginale complète, et rien n’est calibré sur un jeu de données du monde réel. Ce que le programme démontre, c’est le paradigme bayésien lui-même — une distribution de réponses avec une incertitude calibrée — validé par rapport aux postérieures sous forme close là où elles existent, et allant jusqu’à la calibration de modèles dynamiques, la propagation d’incertitude et la comparaison de modèles là où elles n’existent pas. C’est la couche d’incertitude qui peut envelopper n’importe quel autre programme phare.
Continuer à explorer
Cas d’usage associés
 Commande embarquée critique pour la sécuritéNeuf fonctions de sécurité, de l’exigence YAML au Rust embarqué certifiéLe projet de référence du voteur fait passer neuf fonctions de sécurité — vote, verrouillage, limitation de pente, surveillance de déclenchement, verrouillages de sécurité et une jauge de débit avec une frontière en virgule flottante — à travers les treize jalons, et rejoue chacune sur un Cortex-M4F émulé.
 DjiniousSafe
 Commande et apprentissage par renforcementCommande et RL du pendule inversé sur chariotLe benchmark canonique de la commande sous-actionnée, traité de bout en bout — dynamique non linéaire, un LQR qui stabilise le pendule inversé, une mise en mouvement par énergie, une politique d’apprentissage par renforcement sans modèle, et un jalon de robustesse par Monte-Carlo.DjiniousLab
 ÉlectromagnétismeÉlectromagnétisme (FDTD)Résoudre les équations de Maxwell sur une grille — les champs électrique et magnétique progressant en léapfrog dans l’espace et le temps. Un solveur FDTD autonome reproduit les phénomènes ondulatoires canoniques : rayonnement, réfraction, diffraction, diffusion et résonance de cavité. Le pendant en électromagnétisme du solveur de champ CFD.DjiniousLab