 Djinious



Dinamica non lineare
Le equazioni del moto esatte del cart-pole, derivate e integrate. L’equilibrio verticale è genuinamente instabile — ∂θ̈/∂θ > 0 — quindi ogni esecuzione senza controllo si ribalta, la giusta baseline da battere.
La piattaforma
Ogni applicazione svolge una parte del lavoro — e passa le sue evidenze alla successiva. Usale insieme, o una alla volta.
Panoramica della piattaformaScopri come funziona il cicloOrchestrazione
 DjiniousEngineeringOrchestrazione
Progettazione e dimostrazione
 DjiniousLabModellazione e simulazione
 DjiniousWorkshopIntegrazione di sistema
 DjiniousSafeCodice certificabile
Operatività
 DjiniousCCOperatività e SCADADjiniousEngineeringOrchestrazioneDjiniousLabModellazione e simulazioneDjiniousWorkshopIntegrazione di sistemaDjiniousSafeCodice certificabile
 DjiniousWorldRepliche 3D
 DjiniousMapGIS ad agentiDjiniousCCOperatività e SCADA
 DjiniousDataBase di conoscenza
 DjiniousWorkflowAutomazione ad agenti
Il benchmark canonico del controllo sottoattuato, affrontato end-to-end — dinamica non lineare, un LQR che stabilizza il pendolo invertito, un avviamento a oscillazione energetica, una policy di apprendimento per rinforzo model-free, e un gate di robustezza Monte Carlo.
 DjiniousLab

Un’asta incernierata su un carrello, il carrello spinto da una forza orizzontale — il benchmark con cui inizia ogni corso di controlli, e quello a cui torna ogni paper di RL. Qui è un unico programma: la dinamica non lineare esatta, un LQR a stato completo che cattura il pendolo invertito, un avviamento a modellamento energetico, una policy appresa model-free, e un’approvazione finale di robustezza Monte Carlo — l’impianto e il suo stabilizzatore composti anche come un unico .djl eseguibile sul canvas.
Da un modello derivato a mano a una policy che apprende senza alcun modello — ogni metodo è un proprio notebook eseguibile, tutti sullo stesso impianto.
Le equazioni del moto esatte del cart-pole, derivate e integrate. L’equilibrio verticale è genuinamente instabile — ∂θ̈/∂θ > 0 — quindi ogni esecuzione senza controllo si ribalta, la giusta baseline da battere.
Una legge di retroazione a stato completo da lqr(A, B, Q, R) porta ogni autovalore ad anello chiuso nel semipiano sinistro e assesta un’inclinazione di 11° fino alla verticale in 3,68 s.
Una legge di modellamento energetico pompa l’asta dalla posizione pendente facendole compiere l’intero giro, poi passa il controllo all’LQR, che la cattura in verticale a t ≈ 7,2 s.
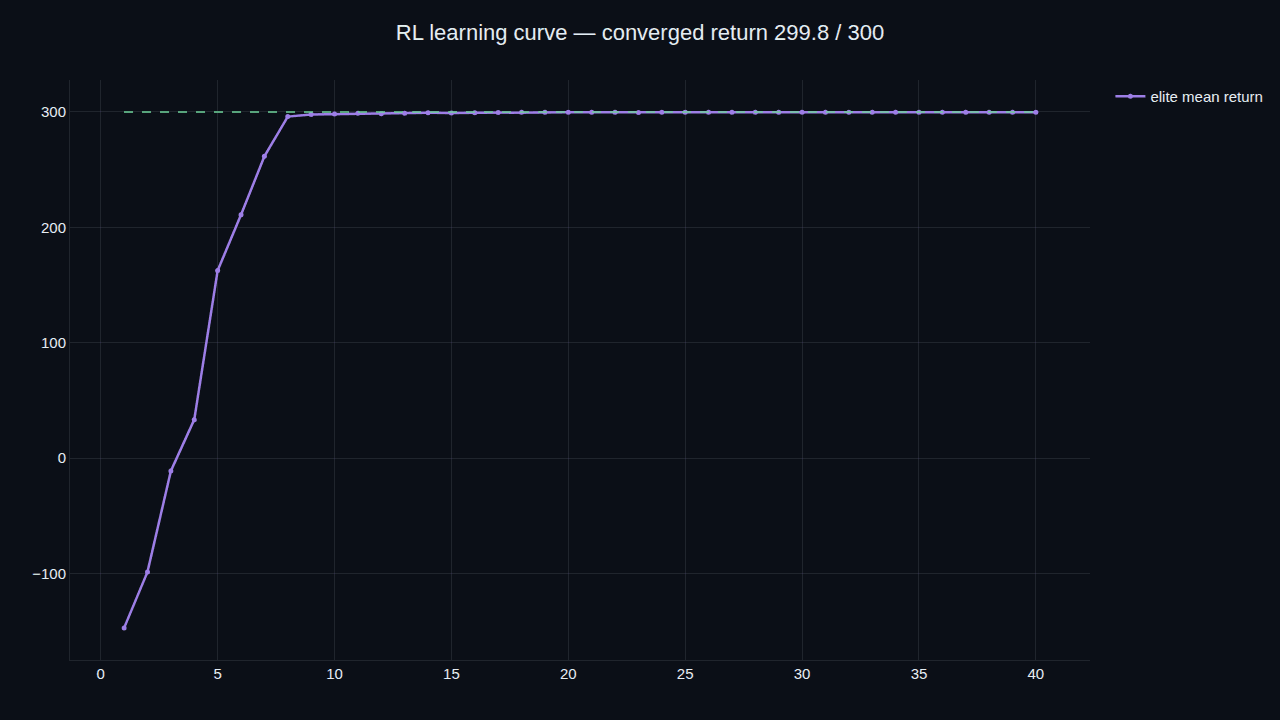
Una policy a metodo dell’entropia incrociata impara a bilanciare da condizioni iniziali casuali senza alcun modello — convergendo a un ritorno di 299,6/300 da una baseline casuale di −220.
Una scansione Monte Carlo di 300 prove perturba massa del carrello, massa e lunghezza dell’asta del ±30% e dà all’asta impulsi improvvisi — tutte e 300 vengono catturate.
Una ricerca Nelder-Mead limitata ritara i pesi dell’LQR rispetto a un costo ad anello chiuso, tagliandolo del 34,5% mentre i guadagni restano fisicamente plausibili.
DjiniousLabL’intero ciclo chiuso — l’impianto cart-pole non lineare e la sua legge LQR a stato completo — è un unico componente .djl acausale. Le sue equazioni sono scritte implicitamente nelle accelerazioni ẍ e θ̈, un piccolo sistema algebrico che il kernel risolve a ogni passo, quindi è un genuino modello differenziale-algebrico che richiede un risolutore stiff Rodas5P, non un passo temporale scritto a mano. Viene tradotto ed eseguito attraverso lo stesso motore di produzione usato dal canvas: rilasciato da un’inclinazione di 0,20 rad, il controllore porta l’asta a 0,005 rad. I guadagni sono gli stessi valori lqr() che i notebook calcolano.
DjiniousLab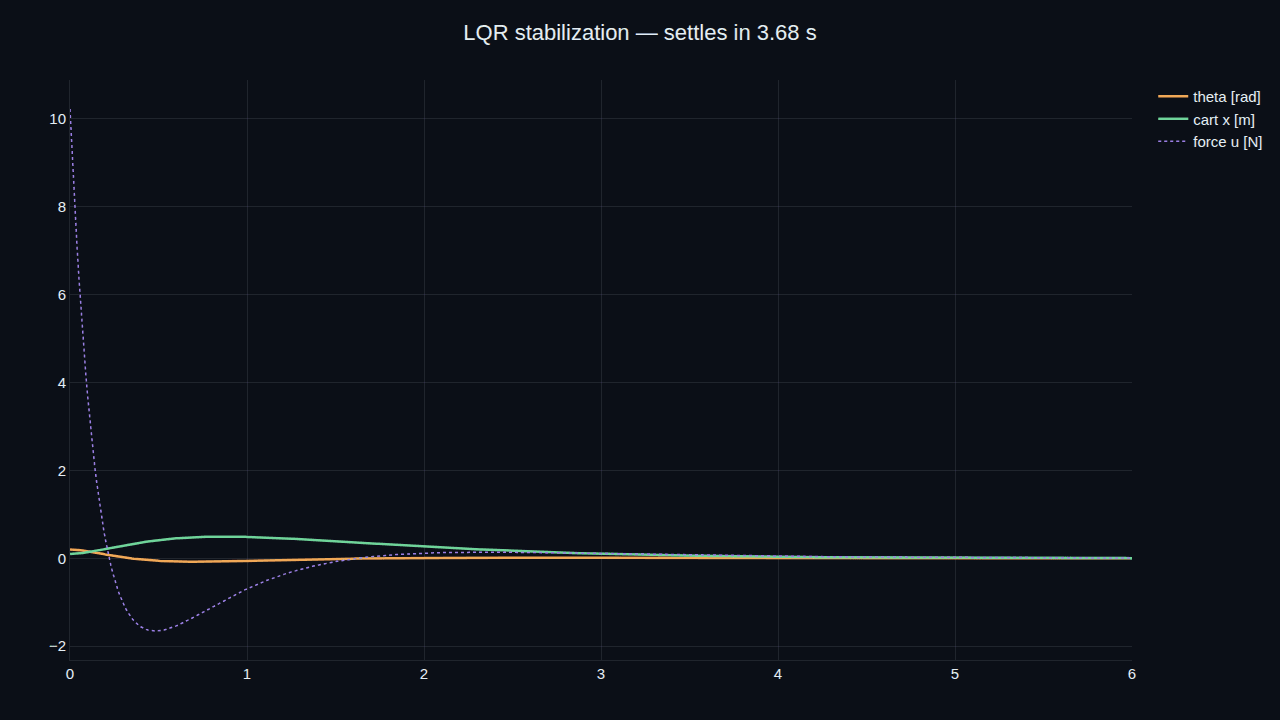 DjiniousLab
Ogni notebook è subordinato al proprio risultato verificato dal worker, e lo stabilizzatore .djl è confermato risolvere attraverso il motore di produzione del canvas.
L’asta è un pendolo a massa puntiforme su un carrello senza attrito — il classico cart-pole da manuale, non un braccio flessibile o multibody. La policy di apprendimento per rinforzo è un metodo lineare dell’entropia incrociata scelto per velocità e riproducibilità, non una rete profonda; l’ottimizzatore è una ricerca locale limitata. Ciò che il programma mostra è l’intero arco — derivare, stabilizzare, avviare a oscillazione, apprendere e verificare — su un unico impianto, con il controllore che vive anche come sorgente acausale componibile che puoi collegare in un sistema più grande.
Continua a esplorare
 Controllo embedded safety-criticalNove funzioni di sicurezza, dal requisito YAML al Rust embedded certificatoIl progetto di riferimento del voter porta nove funzioni di sicurezza — voto, latching, limitazione di slew rate, monitoraggio del trip, interblocchi e un misuratore di flusso con un confine in virgola mobile — attraverso tutti e tredici i gate, e riproduce ognuna su un Cortex-M4F emulato.
 DjiniousSafe
 ElettromagnetismoElettromagnetismo (FDTD)Risolvere le equazioni di Maxwell su una griglia — i campi elettrico e magnetico che si susseguono a salti nello spazio e nel tempo. Un risolutore FDTD autonomo riproduce i fenomeni ondulatori canonici: irradiazione, rifrazione, diffrazione, diffusione e risonanza di cavità. Il fratello a campo del CFD, in elettromagnetismo.DjiniousLab
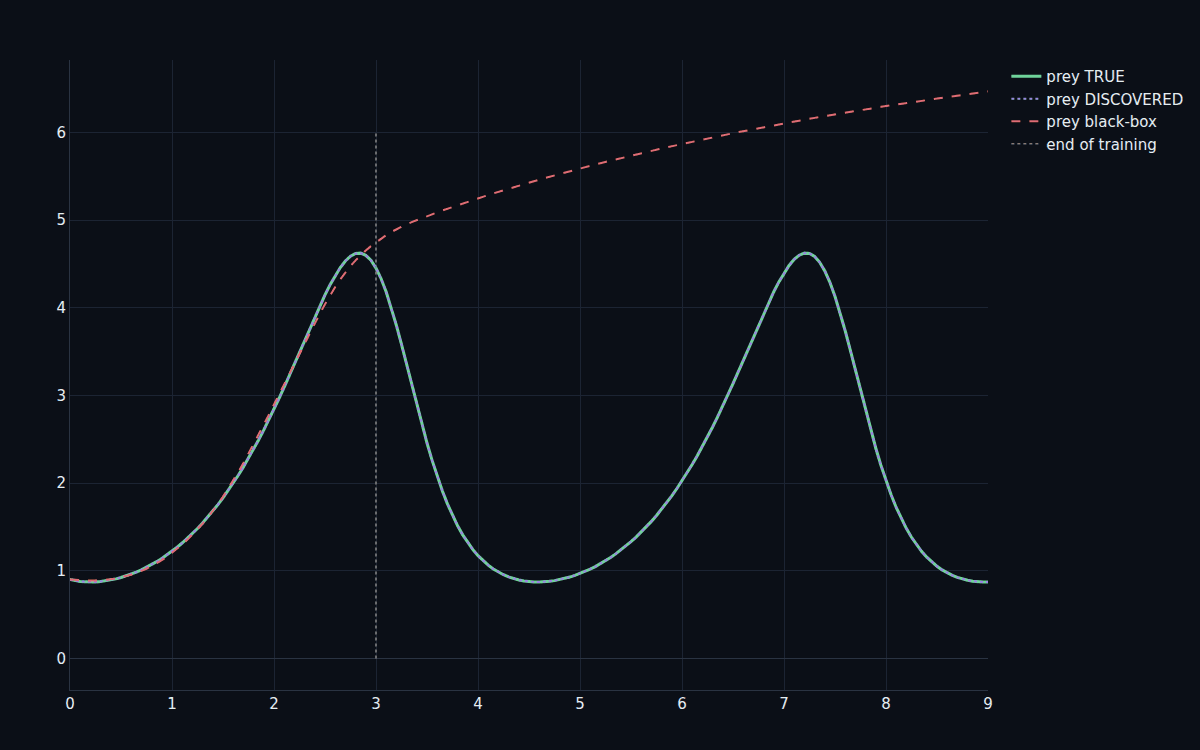 Machine learning scientificoML scientifico (UDE)Scoprire la fisica mancante a partire dai dati con le Universal Differential Equations — mantieni la fisica che conosci, impara il divario con una rete neurale addestrata attraverso il solver ODE, poi rileggi il termine appreso come un’equazione simbolica che estrapola dove un modello a scatola nera non può.DjiniousLab