 Djinious



Dynamique non linéaire
Les équations du mouvement exactes du pendule sur chariot, dérivées et intégrées. L’équilibre vertical est véritablement instable — ∂θ̈/∂θ > 0 — si bien que toute exécution non commandée bascule, la référence de base à battre.
La plateforme
Chaque application prend en charge une partie du travail — et transmet ses preuves à la suivante. Utilisez-les ensemble, ou une à la fois.
Vue d’ensemble de la plateformeVoir comment la boucle fonctionneOrchestration
 DjiniousEngineeringOrchestration
Conception et preuve
 DjiniousLabModélisation et simulation
 DjiniousWorkshopIntégration système
 DjiniousSafeCode certifiable
Exploitation
 DjiniousCCExploitation et SCADADjiniousEngineeringOrchestrationDjiniousLabModélisation et simulationDjiniousWorkshopIntégration systèmeDjiniousSafeCode certifiable
 DjiniousWorldRépliques 3D
 DjiniousMapSIG agentiqueDjiniousCCExploitation et SCADA
 DjiniousDataBase de connaissances
 DjiniousWorkflowAutomatisation agentique
Le benchmark canonique de la commande sous-actionnée, traité de bout en bout — dynamique non linéaire, un LQR qui stabilise le pendule inversé, une mise en mouvement par énergie, une politique d’apprentissage par renforcement sans modèle, et un jalon de robustesse par Monte-Carlo.
 DjiniousLab

Un pendule articulé sur un chariot, le chariot poussé par une force horizontale — le benchmark par lequel commence chaque cours de commande, et celui vers lequel revient chaque article de RL. Ici, c’est un seul programme : la dynamique non linéaire exacte, un LQR à retour d’état complet qui rattrape le pendule inversé, une mise en mouvement par façonnage d’énergie, une politique apprise sans modèle, et une validation de robustesse par Monte-Carlo — le système et son stabilisateur également composés en un seul .djl exécutable sur le canevas.
D’un modèle dérivé à la main à une politique qui apprend sans aucun modèle — chaque méthode est son propre notebook exécutable, toutes sur le même système.
Les équations du mouvement exactes du pendule sur chariot, dérivées et intégrées. L’équilibre vertical est véritablement instable — ∂θ̈/∂θ > 0 — si bien que toute exécution non commandée bascule, la référence de base à battre.
Une loi de retour d’état complet issue de lqr(A, B, Q, R) ramène chaque valeur propre en boucle fermée dans le demi-plan gauche et stabilise une inclinaison de 11° jusqu’à la verticale en 3,68 s.
Une loi de façonnage d’énergie pompe le pendule depuis la position pendante jusqu’à faire le tour complet, puis passe le relais au LQR, qui le rattrape à la verticale à t ≈ 7,2 s.
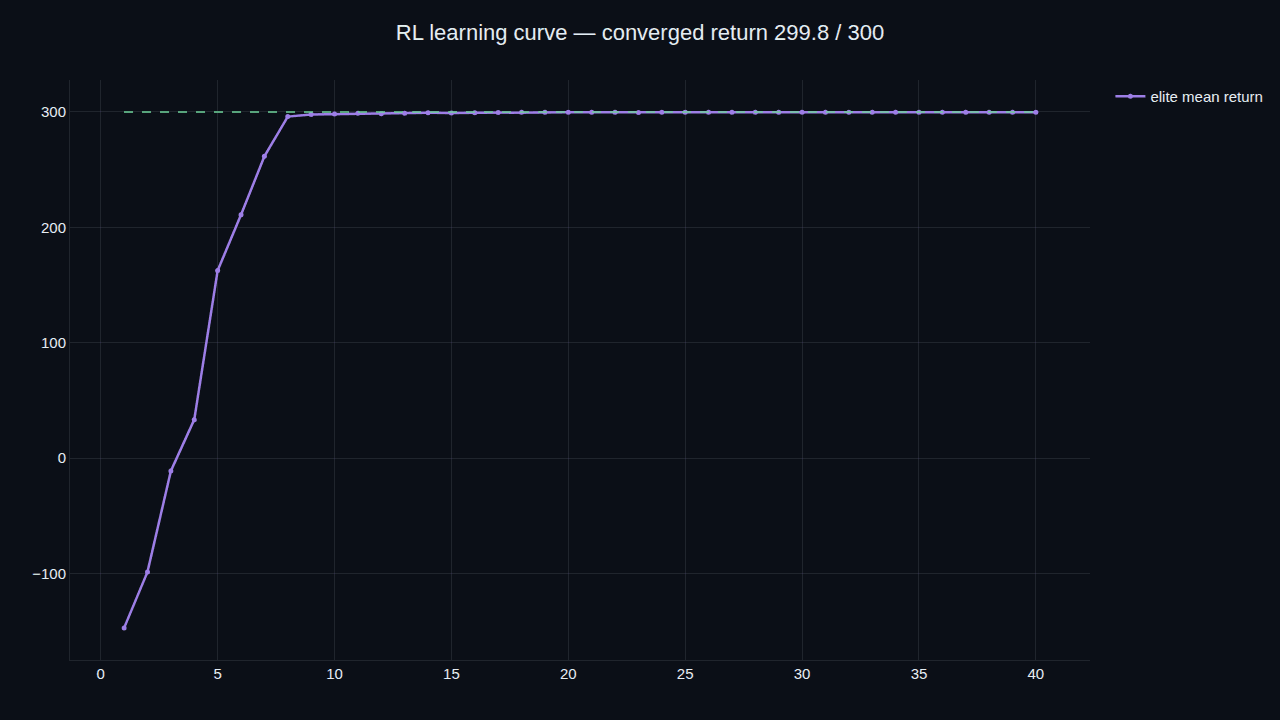
Une politique par méthode d’entropie croisée apprend à équilibrer depuis des conditions initiales aléatoires sans aucun modèle — convergeant vers une récompense de 299,6/300 depuis une référence aléatoire de −220.
Un balayage Monte-Carlo de 300 essais perturbe la masse du chariot, la masse et la longueur du pendule de ±30 % et donne des impulsions au pendule — les 300 sont rattrapés.
Une recherche de Nelder-Mead bornée réajuste les gains du LQR par rapport à un coût en boucle fermée, le réduisant de 34,5 % tout en gardant des gains physiquement réalistes.
DjiniousLabLa boucle fermée entière — le pendule sur chariot non linéaire et sa loi LQR à retour d’état complet — est un seul composant .djl acausal. Ses équations sont écrites implicitement dans les accélérations ẍ et θ̈, un petit système algébrique que le noyau résout à chaque pas, ce qui en fait un véritable modèle différentiel-algébrique nécessitant un solveur raide Rodas5P, pas un pas de temps codé à la main. Il s’abaisse et s’exécute via le même moteur de production que celui utilisé par le canevas : relâché depuis une inclinaison de 0,20 rad, le contrôleur conduit le pendule à 0,005 rad. Les gains sont les mêmes valeurs lqr() que celles calculées par les notebooks.
DjiniousLab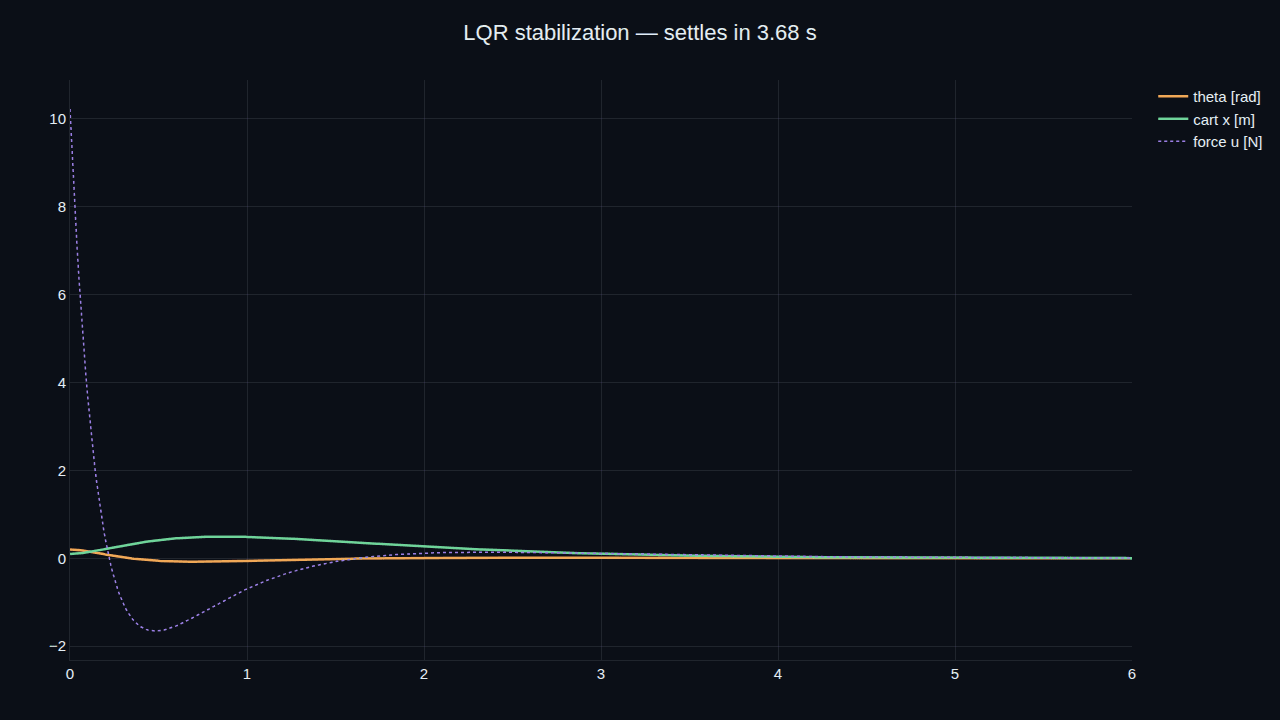 DjiniousLab
Chaque notebook est subordonné à son propre résultat vérifié sur worker, et le stabilisateur .djl est confirmé en résolution via le moteur de production du canevas.
Le pendule est un pendule à masse ponctuelle sur un chariot sans frottement — le pendule sur chariot standard de manuel, pas un bras flexible ou multicorps. La politique d’apprentissage par renforcement est une méthode d’entropie croisée linéaire choisie pour sa rapidité et sa reproductibilité, pas un réseau profond ; l’optimiseur est une recherche locale bornée. Ce que le programme montre est l’arc complet — dériver, stabiliser, mettre en mouvement, apprendre et vérifier — sur un seul système, avec le contrôleur vivant aussi comme source acausale composable que vous pouvez câbler dans un système plus vaste.
Continuer à explorer
 Commande embarquée critique pour la sécuritéNeuf fonctions de sécurité, de l’exigence YAML au Rust embarqué certifiéLe projet de référence du voteur fait passer neuf fonctions de sécurité — vote, verrouillage, limitation de pente, surveillance de déclenchement, verrouillages de sécurité et une jauge de débit avec une frontière en virgule flottante — à travers les treize jalons, et rejoue chacune sur un Cortex-M4F émulé.
 DjiniousSafe
 ÉlectromagnétismeÉlectromagnétisme (FDTD)Résoudre les équations de Maxwell sur une grille — les champs électrique et magnétique progressant en léapfrog dans l’espace et le temps. Un solveur FDTD autonome reproduit les phénomènes ondulatoires canoniques : rayonnement, réfraction, diffraction, diffusion et résonance de cavité. Le pendant en électromagnétisme du solveur de champ CFD.DjiniousLab
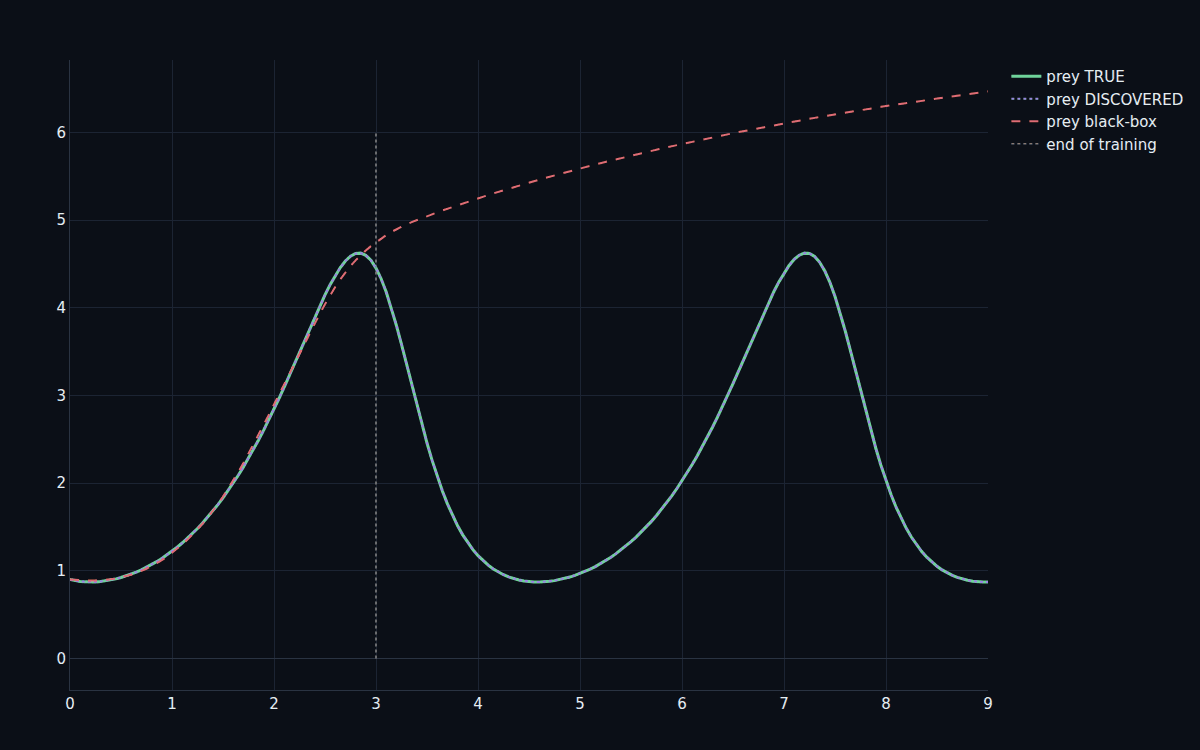 Apprentissage automatique scientifiqueML scientifique (UDE)Découvrir la physique manquante à partir des données avec les équations différentielles universelles (UDE) — conserver la physique connue, apprendre l’écart avec un réseau de neurones entraîné à travers le solveur d’EDO, puis relire le terme appris sous forme d’équation symbolique qui extrapole là où une boîte noire ne le peut pas.DjiniousLab