 Djinious





ML scientifique (UDE)
Découvrir la physique manquante à partir des données avec les équations différentielles universelles (UDE) — conserver la physique connue, apprendre l’écart avec un réseau de neurones entraîné à travers le solveur d’EDO, puis relire le terme appris sous forme d’équation symbolique qui extrapole là où une boîte noire ne le peut pas.
 DjiniousLab
- erreur de coefficient de la récupération symbolique
- 0.0%erreur de coefficient de la récupération symbolique
- corrélation du terme appris
- 0.926corrélation du terme appris
- extrapolation au-delà de la fenêtre d’entraînement
- 3×extrapolation au-delà de la fenêtre d’entraînement
- RMSE d’ajustement du modèle hybride
- 0.065RMSE d’ajustement du modèle hybride
- notebooks de conception
- 10notebooks de conception
- exigences RÉUSSI
- 5 / 5exigences RÉUSSI
L’IA ne se contente pas d’ajuster les données — elle découvre l’équation.
Les modèles réels sont partiellement connus : on dispose de la physique pour l’essentiel d’un système, avec un manque là où la physique est fausse ou absente. Un réseau de neurones boîte noire s’ajuste à la fenêtre d’entraînement, extrapole mal, et ne dit rien. Une équation différentielle universelle conserve chaque terme connu, n’introduit un réseau de neurones que dans le canal inconnu, entraîne le modèle hybride à travers le solveur d’EDO, puis relit l’écart appris sous forme d’équation symbolique par régression parcimonieuse. Ce programme exécute cette boucle de bout en bout sur la pile Julia SciML — et la valide.
On connaît rarement toute la physique — et rarement aucune.
Le système vedette est le modèle proie-prédateur de Lotka-Volterra, avec le terme d’interaction bilinéaire traité comme la physique inconnue : les taux linéaires de naissance et de mort sont connus, le couplage qui fait osciller les populations ne l’est pas. C’est le cas réaliste — un squelette mécaniste avec un trou dedans. Retirez l’interaction et le modèle s’effondre (les proies explosent, les prédateurs s’éteignent) ; les données de l’orbite fermée sont ce à partir de quoi un système d’apprentissage doit reconstruire la fermeture manquante.
DjiniousLab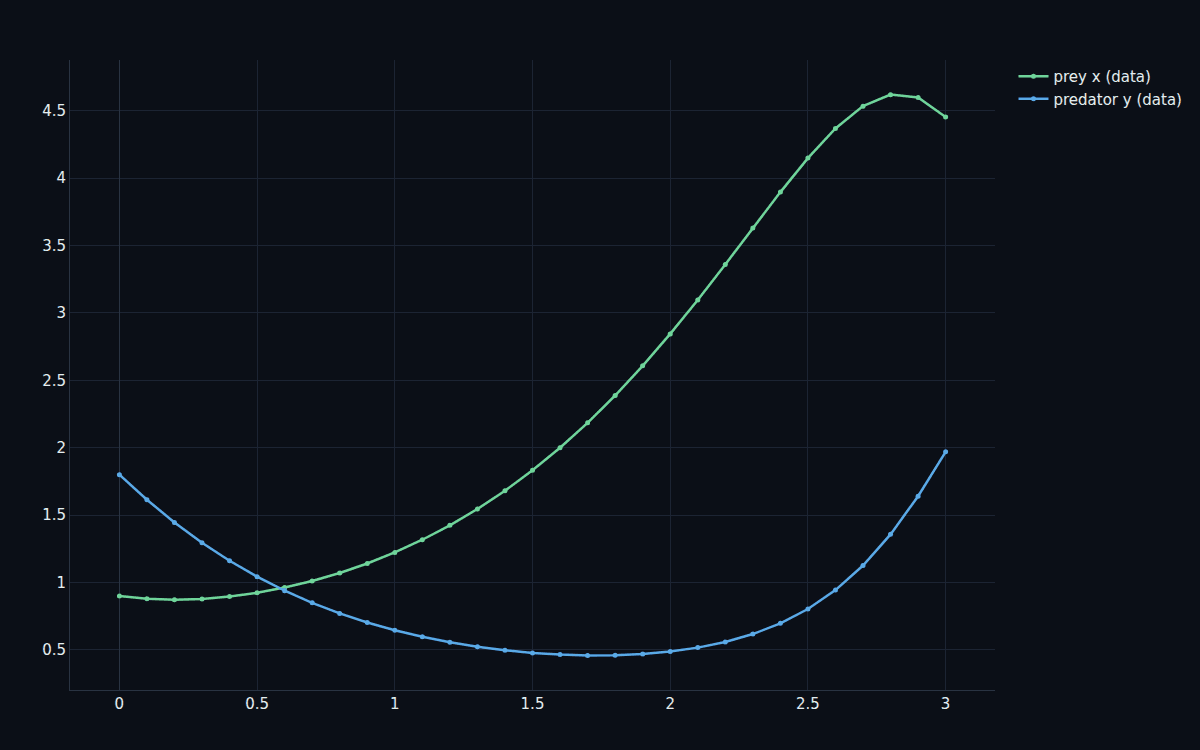
Une boîte noire s’ajuste à la fenêtre et échoue dès qu’elle en sort.
La démarche évidente est d’apprendre tout le membre de droite avec un réseau de neurones — une EDO neuronale. Cela fonctionne à l’intérieur de la fenêtre d’entraînement (RMSE d’ajustement 0,053) et devient complètement inutile en dehors : l’erreur d’extrapolation bondit ×52 et la trajectoire dérive entièrement hors de la variété des données. Elle ne peut non plus rien vous apprendre — il n’y a pas d’équation à lire, pas de physique à vérifier. Cet échec est à lui seul la raison de conserver la physique déjà connue.
DjiniousLab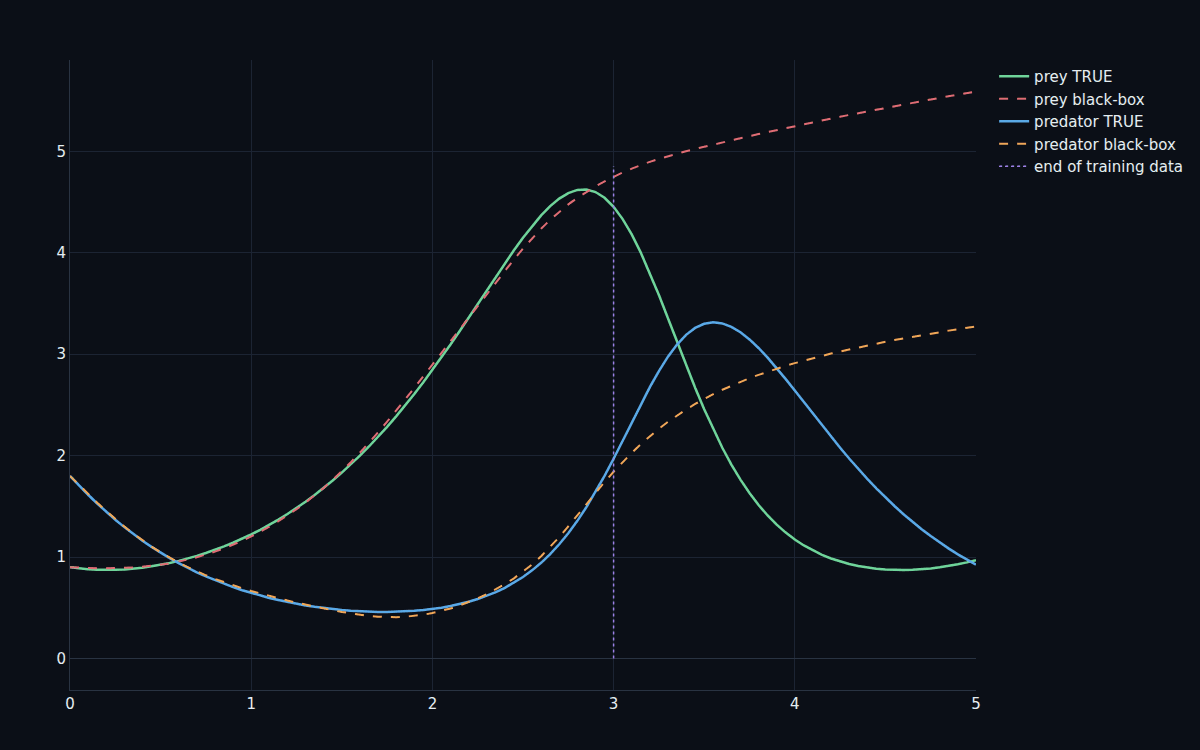
Conserver la physique, n’apprendre que l’écart — à travers le solveur.
L’équation différentielle universelle écrit le membre de droite comme les termes linéaires connus plus un réseau de neurones dans le seul canal d’interaction inconnu, et l’entraîne à travers le solveur d’EDO lui-même — sensibilités adjointes continues (InterpolatingAdjoint + un produit vecteur-jacobien Zygote), les paramètres Lux aplatis en un simple vecteur pour que l’adjoint puisse les voir. La perte de trajectoire chute de 2,4 à 0,0085 sur 1 500 itérations ; le modèle hybride s’ajuste avec une RMSE de 0,065. Et comme le réseau se situe à un endroit connu, on peut examiner ce qu’il a appris : la surface d’interaction apprise correspond au véritable terme −b·xy avec une corrélation de 0,926 / 0,958.
DjiniousLab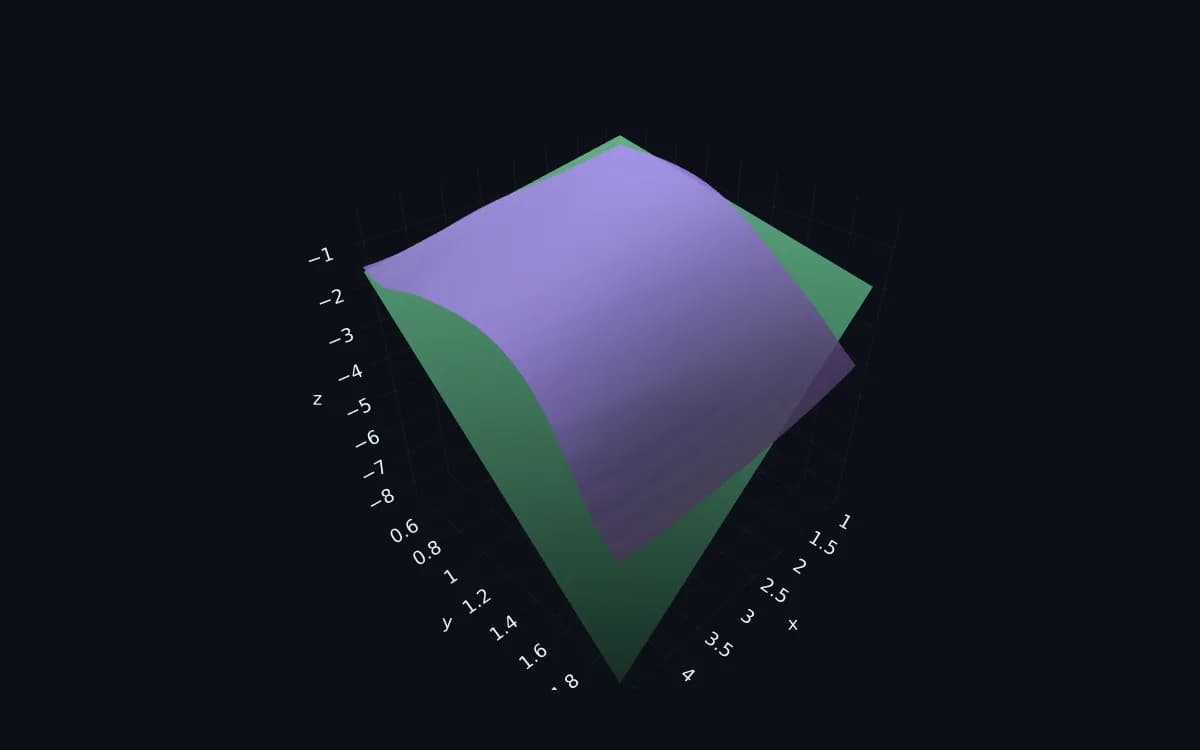
Relire le terme appris sous forme d’équation.
Le terme appris est une fonction lisse dans un canal connu — il peut donc être retranscrit en symboles. Échantillonner le résidu dynamique (dérivée mesurée moins la partie connue) sur un petit ensemble d’orbites et le régresser de façon parcimonieuse sur une bibliothèque de polynômes par moindres carrés à seuillage séquentiel récupère exactement les termes qui conviennent : −0,9·xy pour les proies, +0,8·xy pour les prédateurs, chaque autre candidat ramené à zéro — 0,0 % d’erreur sur les coefficients. Ce n’est pas un ajustement ; c’est l’équation régissante, découverte à partir des données.
DjiniousLab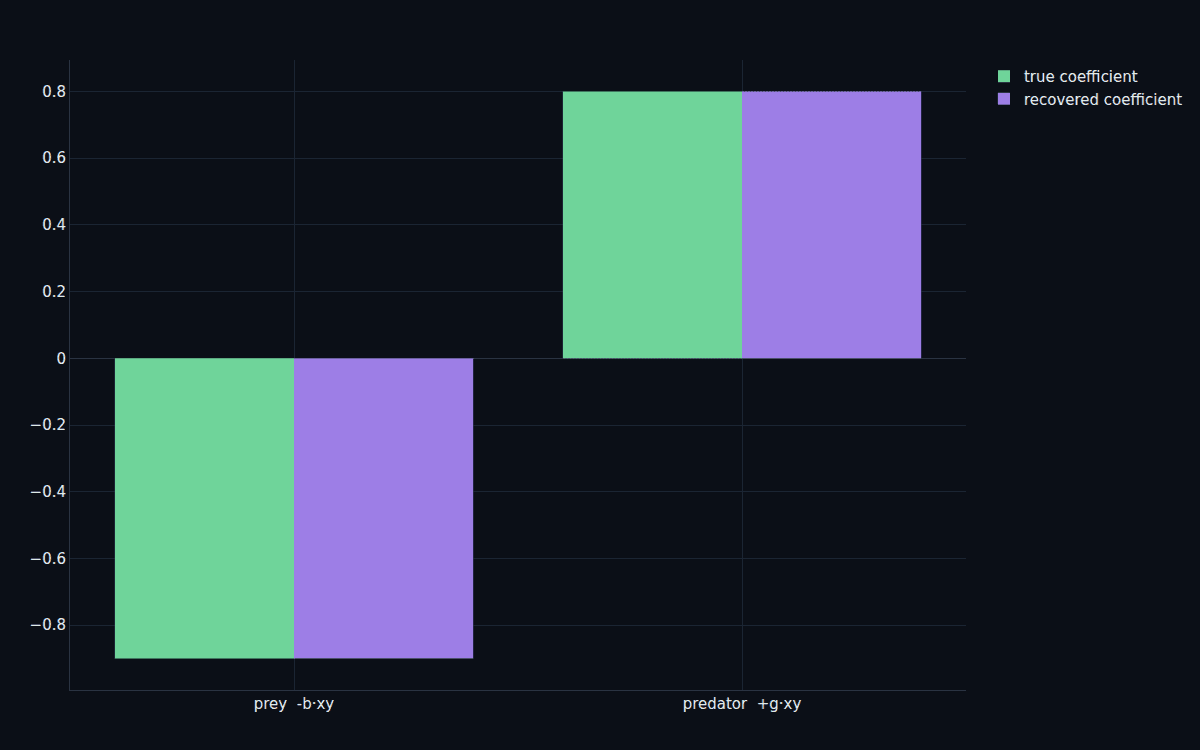
Une loi découverte se généralise ; un ajustement ne le fait pas.
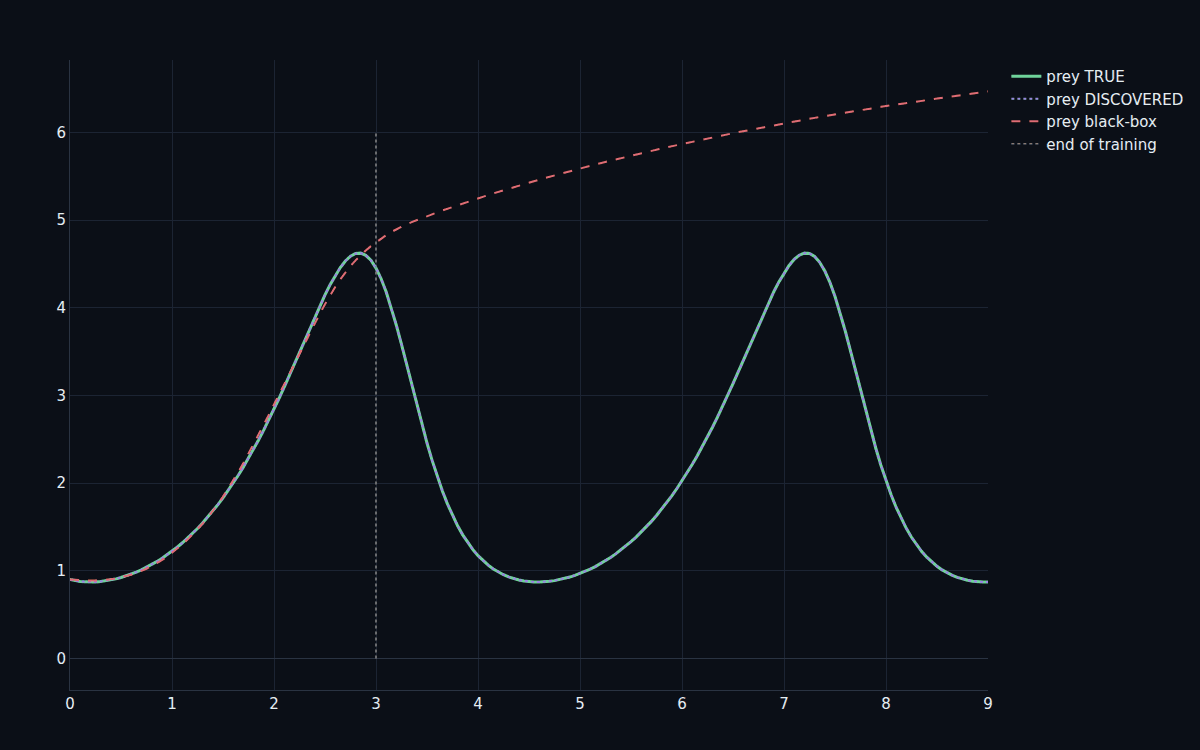
Parce que l’UDE a récupéré la véritable physique manquante, le modèle symbolique découvert prévoit avec une erreur nulle jusqu’à trois fois au-delà de la fenêtre d’entraînement, tandis que l’EDO neuronale boîte noire diverge — la différence entre mémoriser une fenêtre et apprendre une dynamique. Le même pipeline récupère exactement le terme de raideur cubique d’un oscillateur de Duffing amorti, et la récupération de x·y reste sous 1 % d’erreur avec 10 % de bruit de mesure. Des systèmes différents, le même flux de travail : conserver ce que l’on sait, apprendre l’écart, le relire.
Chaque valeur re-dérivée depuis zéro au moment de la validation finale.
Le notebook V&V réentraîne l’UDE, relance la récupération symbolique, entraîne une nouvelle référence boîte noire pour comparaison, et relance la récupération bruitée — puis affiche un tableau RÉUSSI/ÉCHEC.
Résultat
- RMSE d’ajustement du modèle hybride UDE : 0,065
- Corrélation du terme appris : 0,926
- Erreur de récupération symbolique : 0,0 %
- Extrapolation vs boîte noire : ratio 0,0
- Récupération bruitée (bruit à 2 %) : 0,2 %
Exigence
- RMSE d’ajustement du modèle hybride UDE : R-01 < 0,10
- Corrélation du terme appris : R-02 > 0,9
- Erreur de récupération symbolique : R-03 < 10 %
- Extrapolation vs boîte noire : R-04 < 1/3
- Récupération bruitée (bruit à 2 %) : R-05 < 25 %
Une vitrine de méthode sur des systèmes d’école.
Le livrable est dix notebooks et le dossier — pas de blocs personnalisés ni de canevas, car la découverte par UDE est un flux de travail piloté par les données, et non un réseau acausal. Les systèmes sont délibérément petits et pédagogiques (Lotka-Volterra à 2 états, un oscillateur de Duffing) pour que le bénéfice de la découverte soit lisible ; les vraies fermetures — flux turbulents, réseaux de réactions, lois de comportement — sont de dimension plus élevée et demandent des bibliothèques plus grandes et plus de données. La récupération phare est exacte sur des données propres ; le notebook consacré au bruit montre une dégradation progressive, pas magique. La bibliothèque de polynômes est une base fixe et restreinte choisie a priori, et l’entraînement se fait en tir unique (single-shooting). Tout cela figure dans le Périmètre Honnête du dossier — et l’ensemble tourne sur la pile Julia SciML (OrdinaryDiffEq · SciMLSensitivity · Lux · Zygote), une raison concrète de le préférer à MATLAB ici.
Continuer à explorer
Cas d’usage associés
 Commande embarquée critique pour la sécuritéNeuf fonctions de sécurité, de l’exigence YAML au Rust embarqué certifiéLe projet de référence du voteur fait passer neuf fonctions de sécurité — vote, verrouillage, limitation de pente, surveillance de déclenchement, verrouillages de sécurité et une jauge de débit avec une frontière en virgule flottante — à travers les treize jalons, et rejoue chacune sur un Cortex-M4F émulé.
 DjiniousSafe
 Commande et apprentissage par renforcementCommande et RL du pendule inversé sur chariotLe benchmark canonique de la commande sous-actionnée, traité de bout en bout — dynamique non linéaire, un LQR qui stabilise le pendule inversé, une mise en mouvement par énergie, une politique d’apprentissage par renforcement sans modèle, et un jalon de robustesse par Monte-Carlo.DjiniousLab
 ÉlectromagnétismeÉlectromagnétisme (FDTD)Résoudre les équations de Maxwell sur une grille — les champs électrique et magnétique progressant en léapfrog dans l’espace et le temps. Un solveur FDTD autonome reproduit les phénomènes ondulatoires canoniques : rayonnement, réfraction, diffraction, diffusion et résonance de cavité. Le pendant en électromagnétisme du solveur de champ CFD.DjiniousLab